מדריך טכני
המדריך המקיף ל-GEO: אופטימיזציה למנועי AI, מהבסיס ועד ליישום בפועל
איך גורמים למנועי בינה מלאכותית כמו ChatGPT, Gemini ו-Perplexity לצטט אתכם, להמליץ עליכם ולשלב אתכם בתשובה. בעברית, מהיסודות ועד היישום בפועל.
היה ממייסדי Fixel וניהל אותה כמנכ״ל, וב-2020 רכשה אותה Logiq. ראש התמחות בקריה האקדמית אונו.
עיקרי הדברים
- מה זה
- GEO הן הפעולות שגורמות למנוע בינה מלאכותית לצטט אתכם, לשלב אתכם בתשובה ולהמליץ עליכם. זו שכבה נוספת מעל SEO, לא תחליף.
- מה משפיע
- רוב המחקרים של 2026 מתכנסים לאותה מסקנה: חוזק מותג ומה שאחרים אומרים עליכם מנצחים טריקים טכניים. 84% מהציטוטים מגיעים ממקורות צד שלישי, לא מהאתר שלכם.
- מאיפה מתחילים
- לא לחסום את בוטי ה-AI, לרנדר בצד השרת, ולהיות מאונדקסים ב-Bing. אחר כך מותג, דאטה מקורי, ישות ומדידה.
תוכן עניינים
אתגר שפיבק הוא ראש התמחות בקריה האקדמית אונו.
עריכה: דפנה הראל כפיר, עיתונאית, מייסדת אתר פואנטה.
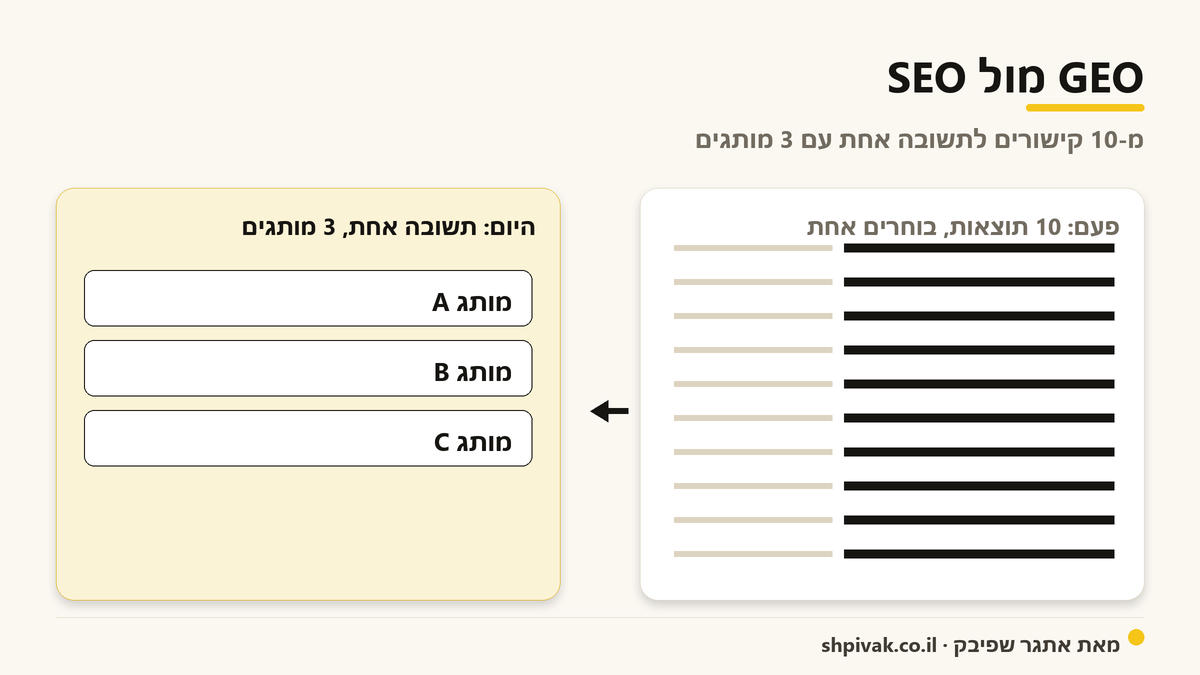
לפני שנתיים-שלוש חיפשתם מוצר, קיבלתם עשרה קישורים כחולים ולחצתם על אחד. היום אתם שואלים את ChatGPT, ומקבלים תשובה אחת עם שלושה מותגים בתוכה. אם המותג שלכם לא אחד מהשלושה, הוא לא קיים. זה כל הסיפור של GEO, ומכאן הכול נגזר.
בקצרה, מה זה GEO? GEO (Generative Engine Optimization) הוא אוסף הפעולות שגורמות למנוע בינה מלאכותית כמו ChatGPT, Gemini או Perplexity לצטט אתכם, לשלב אתכם בתשובה ולהמליץ עליכם. זו שכבה נוספת מעל SEO, לא תחליף: במקום לדרג גבוה בעמוד תוצאות, המטרה היא להפוך למקור שהמנוע סומך עליו ומצטט בתוך התשובה עצמה.
מי קורא מה:
| החלק | למי הוא | אפשר לעצור? |
|---|---|---|
| ראשון | מנהלים ומנכ"לים | כן, אחרי החלק הראשון |
| שני | מנהלי שיווק ותקציבאים | כן, אחרי החלק השני |
| שלישי | אנשי המקצוע שעושים GEO | הבשר הטכני, עד הסוף |
מה יש במדריך הזה, בקצרה:
- מה זה GEO, ולמה זה כבר לא עתידני אלא הדרך שבה אנשים מגלים דברים כבר היום.
- נתח השוק האמיתי של מנועי הבינה, ולמה כל מספר בודד שמישהו שולף לכם מטעה.
- איך מנהל צריך לחשוב על זה, מה לבקש מספק, ואיך לזהות עבודה גרועה.
- הבשר: איך עושים אודיט, איך בונים דף שנשלף ומצוטט, ואיך הופכים לשם שהמנוע ממליץ עליו.
- חיפושי מותג, סושיאל, מחזור תוכן ו-FAQ, כל אחד עם המנגנון ולמה הוא עובד.
- מדידה, כלים בדוקים (חובה מול נחמד), ורמת מומחה.
- סדר עדיפויות מדורג 1-10, כדי לדעת מה עושים קודם.
- לאורך הדרך: כלים קטנים שרצים אצלכם בדפדפן, ואינפוגרפיקות שמסבירות כל נקודה.
המדריך בנוי בשלוש שכבות, וכל אחת ממשיכה את הקודמת.
החלק הראשון הוא למנהלים ומנכ"לים: מה זה GEO, איך זה משפיע עליהם ומה צריך לעשות בגדול.
החלק השני הוא למנהלי שיווק ותקציבאים שעובדים מול איש GEO: השפה, מה לבקש ואיך לנהל את התהליך.
החלק השלישי הוא הבשר, לאיש המקצוע שעושה GEO בעצמו, מהאודיט ועד רמת המומחה. מנהל בכיר יכול לעצור אחרי החלק הראשון, מנהל ביניים אחרי השני, ומי שרוצה את הצד הטכני ממשיך עד הסוף. אני ממליץ בכל זאת לקרוא לפי הסדר, כי כל חלק מתבסס על הקודם.
בתוך המדריך שילבתי כלים קטנים שאפשר להשתמש בהם ישירות. כולם רצים מקומית בדפדפן, בקוד רגיל בלי בינה מלאכותית מאחור, שום נתון לא נשלף ולא נשלח לשום מקום. המידע כאן הוא שלכם, והפרטיות שלכם חשובה לי.
הערה על השפה: GEO הוא תחום צעיר ומלא הייפ. הוא משתנה בקצב מהיר, ויש בו הרבה מספרים שמסתובבים בלי גיבוי. השתדלתי לתת רק מה שמגובה במקורות, לצרף לינק לכל מחקר עם חודש ושנה, ולהציג שתי דעות כשהתחום חלוק. בנושא שאין לגביו נתון מוצק, כתבתי שאין.
חלק ראשון: למנהלים. מה זה GEO ולמה זה כבר משנה לכם
מה זה GEO?
שלוש האותיות GEO הן ראשי תיבות של Generative Engine Optimization, אופטימיזציה למנועים גנרטיביים. במילים פשוטות: הפעולות שגורמות למנוע בינה מלאכותית כמו ChatGPT, Gemini, Claude או Perplexity לצטט אתכם, לשלב אתכם בתשובה ולהמליץ עליכם כשמישהו שואל שאלה.
זה לא SEO (אופטימיזציה למנועי חיפוש) בשם חדש, וזה גם לא מחליף SEO. זו שכבה נוספת מעליו. ב-SEO השאלה היא "איך מדורגים גבוה בעמוד התוצאות". ב-GEO השאלה היא "איך הופכים למקור שהמנוע סומך עליו ומצטט בתוך התשובה".
ההבדל דק אבל קריטי: בעולם של קישורים כחולים, מקום שני ומקום שביעי שניהם מקבלים קליקים. בעולם של תשובת AI, המנוע מצטט רשימה קצרה של מותגים, ומי שלא ברשימה - כמעט לא קיים. זה קרוב יותר לציון של "עובר או נכשל" במבחן, מאשר לדירוג הדרגתי.
מאיפה המונח בא
המונח נטבע במאמר מ-2023 (GEO: Generative Engine Optimization ב-arXiv, שהתקבל ל-KDD 2024), שבדק מנוע גנרטיבי מדומה שהחוקרים בנו, ומצא עלייה של עד 40% במדד נראות שהם עצמם הגדירו (נתח טקסט מיוחס בתשובה), לא בתנועה ולא בדירוג. משם הגיע הרעיון: ציטוטים, סטטיסטיקה ומקורות עוזרים, ודחיסת מילות מפתח מזיקה. הוא המחקר המכונן, לא היחיד: מאז הצטרפו ניסויים מבוקרים נוספים, ובראשם מחקר SIGIR 2026 על 252,000 ריצות, וסקירה ביקורתית מ-2026 שמזהירה שרווח במעבדה עדיין לא מוכיח תנועה אמיתית.
מה זה AEO ומה ההבדל בינו לבין GEO ו-SEO?
ראשי התיבות AEO הם Answer Engine Optimization. זה השם הוותיק יותר לעבודה שגורמת למנוע לבחור בתוכן שלכם כתשובה הישירה, החל מה-Featured Snippet של גוגל, קופסת התשובה שמעל התוצאות. GEO הוא השם שבו משתמשים המחקר וויקיפדיה לאותה מטרה בתוך תשובות של מנועי AI. SEO הוא הבסיס של שניהם, ובפועל רוב האנשים משתמשים בשני המונחים כמילים נרדפות.
את המונח טבע לדבריו Jason Barnard ב-2017, כשה-Featured Snippets של גוגל התחילו לדחוק הצידה את עשרת הקישורים הכחולים. בוויקיפדיה האנגלית הערך answer engine optimization מפנה לערך GEO, עם הערה שנכון לתחילת 2026 אין במחקר הגדרה מוסכמת שמבדילה בין המונחים. וגוגל, במדריך שלה ל-AI בחיפוש (עודכן ביולי 2026), כותבת שמבחינתה שניהם עדיין SEO.
SEO, AEO ו-GEO, זה לצד זה:
| השוואה לפי | SEO | AEO | GEO |
|---|---|---|---|
| המטרה | להיות מדורגים גבוה בעמוד התוצאות | להיבחר כתשובה הישירה | להיות מצוטטים, משולבים בתשובה ומומלצים |
| איפה התשובה מופיעה | עשרת הקישורים הכחולים | ה-Featured Snippet מעל הקישורים, או תשובה של עוזר קולי | ChatGPT, Gemini, Perplexity, Claude, Copilot, AI Overviews ו-AI Mode |
| יחידת העבודה | העמוד | הקטע האחד שעונה על השאלה | הפסקה, ועוד מה שאחרים אומרים עליכם (Earned Media) |
| המנוף המרכזי | רלוונטיות, תקינות טכנית וקישורים | תשובה קצרה וישירה מיד מתחת לכותרת בצורת שאלה | חוזק מותג, אזכורים ברשת ועמודים שמנוע יכול לצטט |
| איך מודדים הצלחה | דירוגים, קליקים ותנועה אורגנית | Featured Snippets ותשובות ישירות שזכיתם בהם | אזכורים, ציטוטים ונתח קול (Share of Voice) על מאגר שאלות קבוע |
נתח מנועי הבינה: תמיד לשאול "איזה מדד"
אין מספר אחד לנתח השוק של מנועי הבינה, וזו הנקודה הראשונה. נתח השוק של ChatGPT נע בין 46% ל-78%, והכול תלוי במה בדיוק סופרים. מי ששולף מספר בודד בלי לומר את המדד, מטעה אתכם. יש שלושה מדדים שונים, וכולם לגיטימיים.
מדד ראשון: קהל פעיל (אפליקציה ואתר)
לפי Sensor Tower (מדד True Audience, שמונה משתמשים ייחודיים באפליקציה ובאתר, נתונים עד סוף מאי 2026): ChatGPT מחזיק ב-46.4%, Gemini ב-27.7%, ו-Claude ב-10.3%. זו הכותרת "ChatGPT ירד מתחת ל-50% לראשונה". הוא החזיק מעל חצי עד ינואר 2026, ירד מתחת ל-50% במרץ, ובסוף מאי עמד על 46.4%.
מדד שני: אימוץ בקרב האוכלוסייה
מחקר Pew (מדגם מייצג של 5,119 אמריקאים, שדה בפברואר 2026 ופרסום ביוני 2026, המקור הכי אמין כאן) מצא שכמחצית מהאמריקאים משתמשים בצ'אטבוט בינה מלאכותית (49% היום לעומת שליש ב-2024).
ChatGPT הוא הצ'אטבוט העיקרי (44% השתמשו בו אי פעם, Gemini אחריו עם 24% ו-Copilot עם 17%).
42% משתמשים בצ'אטבוט כדי לחפש מידע, ו-60% מהאמריקאים קוראים את סיכומי ה-AI שמופיעים בראש תוצאות החיפוש.
מדד שלישי: תעבורת הפניה לאתרים
זה המדד הכי רלוונטי אם אכפת לכם מתנועה לאתר, והוא נוטה הרבה יותר חזק ל-ChatGPT. לפי StatCounter (מרץ 2026): ChatGPT שולח 78% מתעבורת ההפניה שמגיעה מצ'אטבוטים, Gemini שולח 8.65%, Perplexity שולח 7% ו-Claude שולח כמעט 3%. מחקר של SE Ranking על 101,574 אתרים נותן מספרים דומים: ChatGPT שולח כ-75% ו-Gemini כ-11.5%.
המדד שכולם שוכחים: הבינה בתוך גוגל עצמה
כשמדברים על "תנועה מ-AI" קל לשכוח שהמקום הגדול ביותר הוא לא צ'אטבוט נפרד, אלא ה-AI Overviews של גוגל, סיכומי הבינה שמופיעים בראש תוצאות החיפוש הרגילות. לפי BrightEdge הם הופיעו על כ-48% משאילתות המעקב שלהם בתחילת 2026, ובפאנלים רחבים יותר השיעור נמוך משמעותית (Semrush: כ-16% מהחיפושים בארה"ב, ועד כ-39% משאילתות מידע).
כך או כך, 60% מהאמריקאים קוראים אותם, והם מגיעים ליותר אנשים מכל הצ'אטבוטים הנפרדים ביחד. הכוונה שונה: מי שקורא סיכום בגוגל לרוב לא "משוחח", הוא מחפש. אבל מבחינת נראות, זה המקום שבו הכי הרבה אנשים פוגשים תשובת AI וגם הכי הרבה תנועה נעצרת שם.
לכן, במיוחד בישראל, לא הייתי מודד GEO רק לפי ChatGPT.
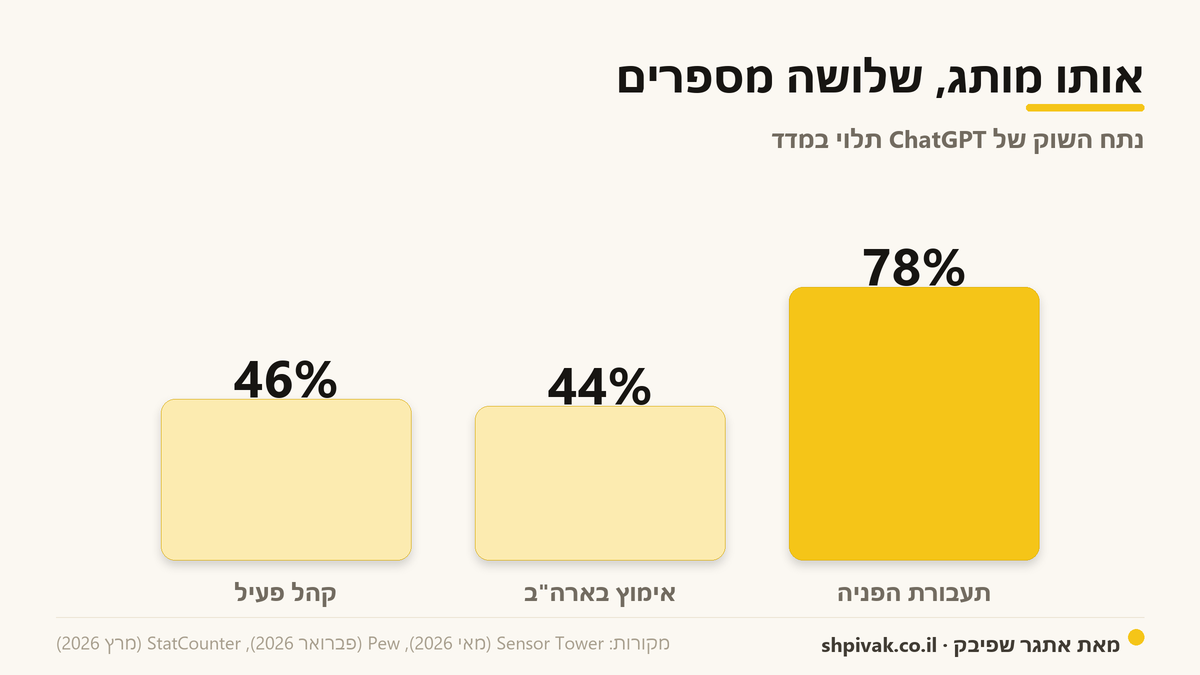
מה שחשוב לזכור: ChatGPT מוביל בכל מדד וממשיך לגדול במספרים מוחלטים (Pew: מ-34% ל-44% בשנה), אבל הנתח שלו יורד בכל מדד כי המתחרים גדלים מהר יותר. Gemini הוא השני הברור והצומח הכי הרבה בנקודות אחוז. Claude צומח הכי מהר יחסית אבל נשאר קטן. וחשוב מהכול: אלה מדדים שונים, אז אל תשוו מספר של "שימוש באפליקציה" למספר של "תעבורת הפניה". הם מודדים דברים שונים.
ומה בישראל?
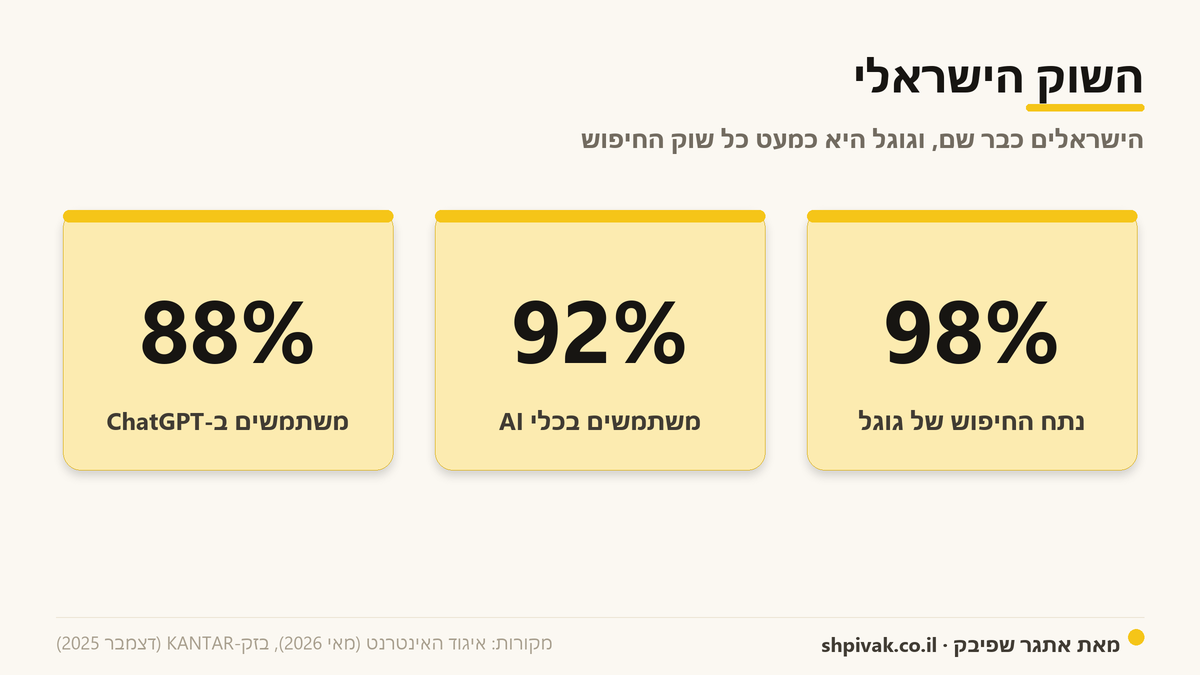
לפי מדד האינטרנט של ישראל 2026 של איגוד האינטרנט (סקר מייצג, מאי 2026), 88% מהישראלים הבוגרים משתמשים ב-ChatGPT (85% ב-2025), יותר מאינסטגרם (82%), אם כי השימוש היומי בו ירד מ-46% ל-35%. Gemini קפץ בשנה מ-49% ל-73%. דוח האינטרנט של בזק (עם KANTAR, דצמבר 2025, מדגם של 4,750 איש) מוסיף שכ-92% מהישראלים משתמשים בכלי בינה מלאכותית כלשהו, בממוצע כשעה וחצי ביום, וכ-20% כבר משלמים על כלי AI.
לפני שאתם מתלהבים מהמספר הגדול, שווה לדייק: 88% "משתמשים ב-ChatGPT", כ-92% "משתמשים בכלי AI כלשהו", ו-38% לפי מדד ה-AI Diffusion של מיקרוסופט (רבעון ראשון 2026), שמודד בטלמטריה (מדידה אוטומטית מהמכשירים), לא בדיווח עצמי, כמה מבני 15-64 השתמשו בפועל בכלי AI גנרטיבי. אלה לא מספרים סותרים, הם מודדים הגדרות שונות. אבל הכיוון ברור: הישראלים כבר שם.
נקודה ישראלית שחשוב להכיר: מבחינת מנוע החיפוש, גוגל שולטת בישראל כמעט לגמרי, מעל 98% נכון לאמצע 2026. הדומיננטיות הזו מצדיקה לכלול את תכונות ה-AI של גוגל (AI Overviews) באסטרטגיה לישראל. היא לבדה לא מוכיחה שרוב חוויות ה-AI של הישראלי קורות שם, כי ChatGPT הוא מוצר נפרד ש-88% משתמשים בו. בקצרה: בתוך חיפוש גוגל, ה-AI Overviews הם נקודת המגע העיקרית, ובמקביל ChatGPT הוא הכלי הישיר הדומיננטי.
למה זה משנה לכם?
שלושה דברים קורים במקביל, וכל אחד מהם עלול להשפיע עליכם ישירות.
לאן נעלם הקליק?
לפי ניתוח של SparkToro (ינואר עד אפריל 2026), כ-68% מחיפושי גוגל בארה"ב מסתיימים בלי אף קליק לאתר, עלייה מ-60% ב-2024 (מקורות אחרים מודדים נמוך יותר, בטווח 58% עד 65%, אז קחו את המספר כטווח). וכשמופיע סיכום AI, ההשפעה על הקליקים חדה: מחקר Ahrefs (פברואר 2026, נתוני דצמבר 2025, 300,000 מילות מפתח) מצא שאחוז ההקלקה על התוצאה הראשונה נקשר לירידה של כ-58% ביחס לצפוי כשיש AI Overview, כמעט פי 1.7 מהירידה של 34.5% שמדדו באפריל 2025. במילים אחרות, יותר ויותר אנשים מקבלים את התשובה בלי להגיע אליכם בכלל.
למה אזכור שווה יותר מקליק?
אם אף אחד לא לוחץ, מה שנשאר חשוב הוא אם הוזכרתם בתשובה עצמה. להיות מצוטט הפך חשוב יותר מלזכות בקליק. זה שינוי תפיסתי שלוקח למנהלים זמן לעכל: המדד כבר לא "כמה תנועה קיבלנו", אלא "האם המנוע ממליץ עלינו כשמישהו שואל".
למה מותג חזק מנצח את הטריקים?
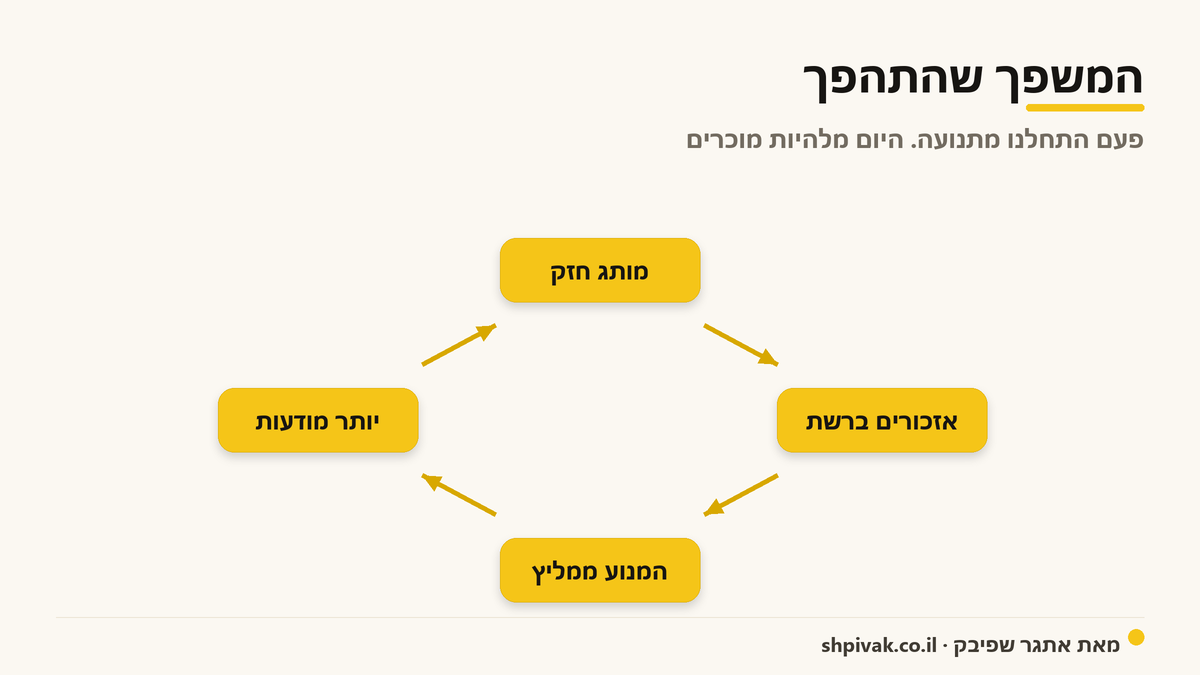
וכאן דווקא יתרון למי שבנה מותג חזק. רוב המחקרים הרציניים של 2026 מתכנסים לאותה מסקנה: מה שבאמת משפיע הוא חוזק המותג והנוכחות מחוץ לאתר שלכם, לא הטריקים הטכניים. Ahrefs בדקו 75,000 מותגים (מאי ודצמבר 2025) ומצאו שאזכורי מותג ברשת, ובמיוחד ביוטיוב, מתואמים הרבה יותר חזק עם נראות ב-AI מאשר קישורים נכנסים (מתאם 0.66-0.74 לעומת כ-0.2). זה מתאם, לא הוכחת סיבתיות, אבל הכיוון עקבי.
תרגום למנהלים: ההשקעה שלכם במותג, ב-PR וביצירת מודעות היא בדיוק מה שגורם ל-AI להמליץ עליכם. GEO הוא, במידה רבה, בניית ביקוש.
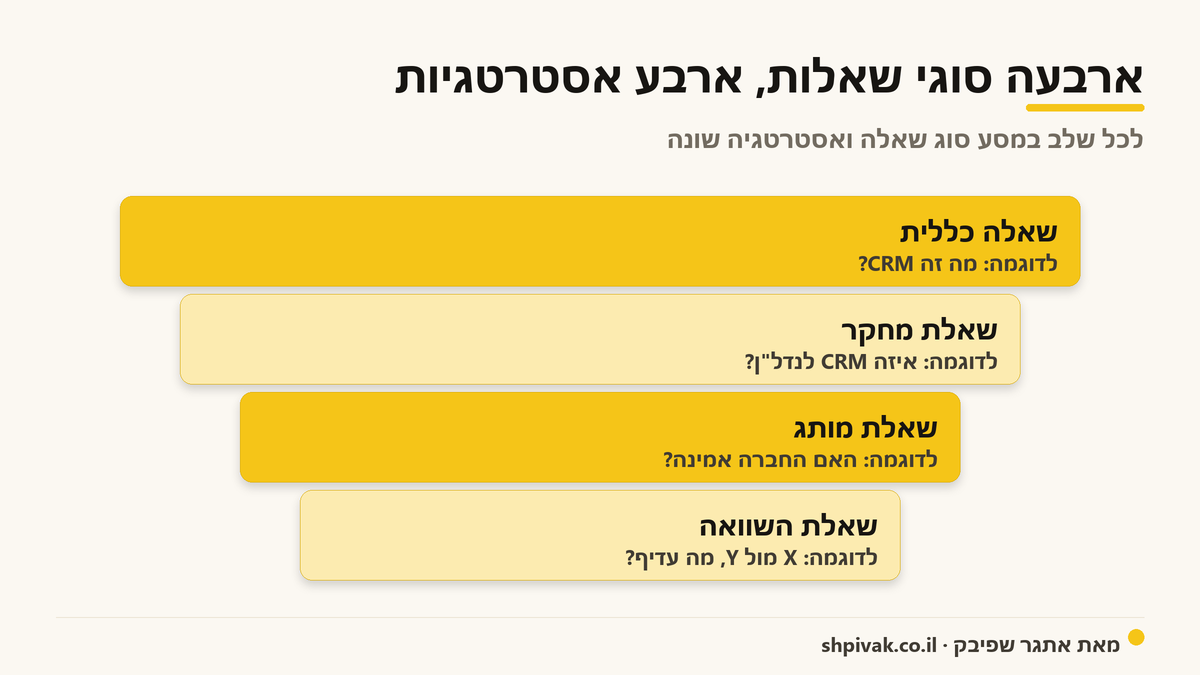
ארבע סוגי השאלות שכל מנהל צריך להכיר
לא כל השאלות זהות. משתמש שואל דברים שונים לפי המצב שלו, ואסטרטגיית ה-GEO משתנה בהתאם. ארבעה סוגים, בחלוקה שלי (היא מקבילה לחלוקת המשפך TOFU/MOFU/BOFU (ראש, אמצע ותחתית המשפך) שמופיעה אצל GoVISIBLE ואחרים).
שאלות כלליות על התחום
לדוגמה: "מה זה CRM", "איך עובד onboarding ללקוחות".
כאן המשתמש עוד לא חושב על מותג. המנוע מחפש את מי שמסביר את הקטגוריה בסמכות.
הזכייה כאן היא להיות המקור שמסביר את התחום, לא לדחוף את השם שלכם.
עבור חברות B2B (עסקים שמוכרים לעסקים) זו לרוב ההשקעה הגדולה ביותר בטווח הארוך, אבל גם היקרה והאיטית, ולכן היא באה אחרי שסגרתם את שאלות המותג וההשוואה. הלקוח שואל את השאלות האלה עוד לפני שהוא מכיר ספק. במקרים רבים אין פה בכלל "ספקים" בתחום, אלא רק הסבר כללי על הקטגוריה.
שאלות מחקר ושיקול
לדוגמה: "איזה CRM הכי מתאים לעסק קטן בתחום הנדל"ן", "מה הכלי הנכון לצוות של חמישה אנשים".
כאן המשתמש כבר מחפש התאמה למצב הספציפי שלו, אבל עדיין פתוח. המנוע בונה רשימה קצרה משיקולים (גודל, תחום, תקציב), ולרוב שואב אותה ממקורות צד שלישי שממפים אפשרויות.
הזכייה כאן היא להופיע בהשוואות ובמדריכים שממפים את השוק לפי צורך, ולהחזיק תוכן משלכם שעונה בדיוק על ההתלבטות הזו. זה השלב שבו נכנסים ל"סט השיקול", וממנו נגזרת הבחירה.
שאלות מותג
לדוגמה: "מה אתגר שפיבק עושה", "האם החברה הזו אמינה".
כאן המנוע בונה את התשובה בעיקר ממקורות צד שלישי, לא מהאתר שלכם. שתי שאלות קריטיות: האם המנוע בכלל מכיר אתכם, והאם הוא מתאר אתכם נכון. תיאור מוטעה של המותג בתשובות הוא לא בעיה של תוכן, אלא של ניהול ישות (איך המנוע מזהה אתכם כדבר אחד ברור) ומוניטין.
זה גם המקום להתחיל בו: החלק הראשון של עבודת ה-GEO צריך להתמקד דווקא בשאלות המותג, כי אלה אנשים שכבר רוצים לבדוק אתכם, וצריך לוודא שהם מקבלים את התשובה שאתם רוצים.
שאלות השוואה
לדוגמה: "X מול Y", "הכלי הכי טוב ל-SaaS קטן", "אלטרנטיבות ל-Z". אלה שאלות הקנייה, הכי תחרותיות והכי שוות. כאן המנוע נשען חזק על רשימות ודירוגים של צד שלישי.
אז מה המנהלים צריכים לעשות?
לא צריך שתהפכו למומחי GEO. צריך שתדעו לאן לכוון את המשאבים ומה לצפות. סדר העדיפויות בתהליך: להתחיל מהשאלות שכבר שואלים עליכם בשם (שאלות מותג), אחר כך שאלות ההשוואה בקטגוריה, ורק בסוף השאלות הכלליות על התחום.
למה להשקיע במותג ובישות, לא בטריקים?
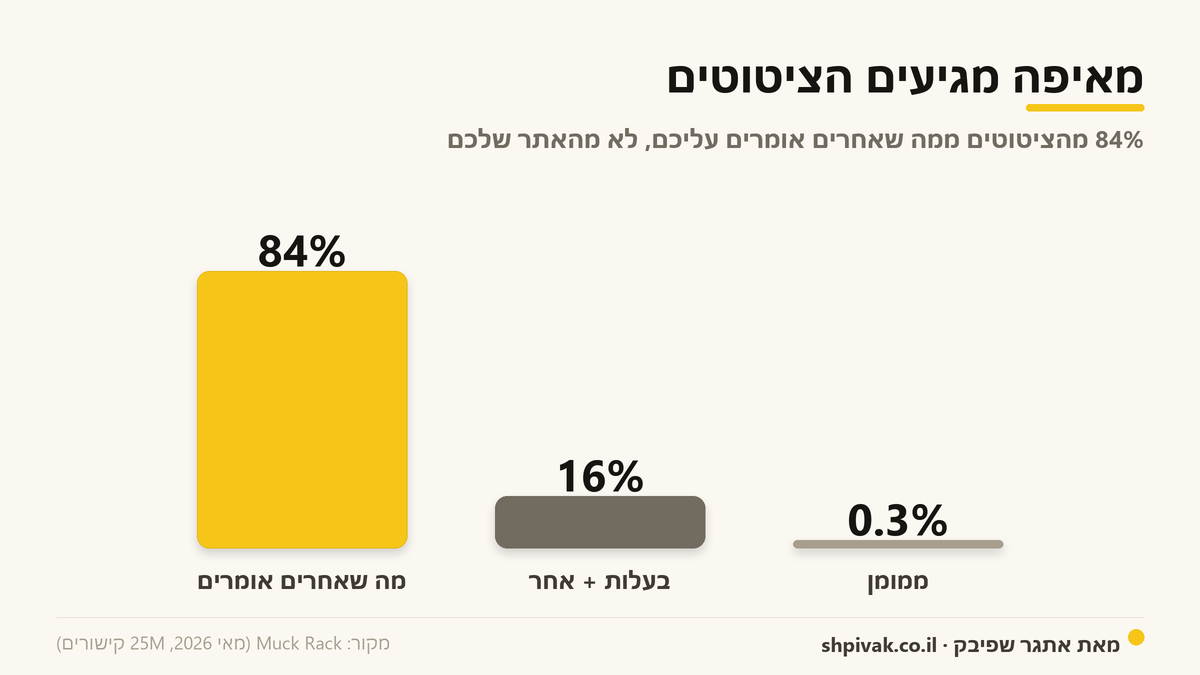
"ישות" (entity) היא איך שהמנוע מזהה אתכם כדבר אחד ברור בעולם: השם, התחום, האנשים שמאחוריכם, והקישור בין כל אלה למותג אחד. אם יש דבר אחד שחוזר בכל מחקר של 2026, הוא שמה שאחרים אומרים עליכם (אזכורים וכתבות שהרווחתם בזכות התוכן והמוניטין, לא פרסום ששילמתם עליו) וחוזק מותג מנצחים תוכן עצמי וקישורים. Muck Rack מצאו (מאי 2026, 25 מיליון קישורים) ש-84% מהציטוטים של ה-AI מגיעים ממה שאחרים אומרים עליכם. תקציב שהולך ל-PR אמיתי, למחקר מקורי שמצטטים, ולהיות נוכח באתרים שהמנוע סומך עליהם, עובד יותר טוב מתקציב שרודף אחרי טריקים טכניים.
למה לצפות לתהליך איטי - ולמדוד נכון?
GEO לא נותן תוצאות בשבוע. הציטוטים מתחילים לזוז בדרך כלל בין שבוע 6 לשבוע 12, ולכן ניסיון של 30 יום הוא חסר טעם. Siege Media מעריכים שההשפעה האמיתית של AI גבוהה ב-100% עד 200% ממה שהאנליטיקס מראה. בדיקות אחרות מראות שהיא יכולה להיות גדולה אף בסדר גודל, יותר מפי 10 ממה שרואים באנליטיקס של האתר.
המסקנה הניהולית: אל תחכו למספר מושלם, תתחילו למדוד עכשיו ותסתכלו על שלושה אותות יחד: תעבורת AI, נתח קול בתשובות (כמה מהן מזכירות אתכם מול המתחרים) ועלייה בחיפושי המותג שלכם בגוגל.
מה אפשר להבטיח להנהלה, ומה לא?
אם אתם מדווחים למנכ"ל או לדירקטוריון, אל תבטיחו מיקום מסוים, אל תבטיחו שאופטימיזציה חד-פעמית תחזיק לאורך זמן ואל תבטיחו ייחוס מדויק. שום פלטפורמה לא נותנת את זה. מה שכן אפשר להבטיח: מדידה שיטתית ומגמה שמשתפרת לאורך זמן.
זה הבסיס. מי שרוצה רק להבין את התמונה הגדולה, יכול לעצור כאן. מי שצריך לנהל את התהליך בפועל, החלק הבא הוא בשבילו.
חלק שני: לתקציבאים ומנהלי שיווק. איך לעבוד בצורה אפקטיבית עם איש GEO?
החלק הזה הוא בשביל מי שלא עושה את ה-GEO בעצמו, אבל אחראי עליו. אתם מנהלי הלקוח, התקציבאים, מנהלי השיווק שצריכים לתדרך ספק, לאשר תקציב, ולהבין אם העבודה טובה. כדי לנהל תהליך אתם צריכים להבין את השפה, לדעת מה לבקש, ואיך לזהות עבודה גרועה.
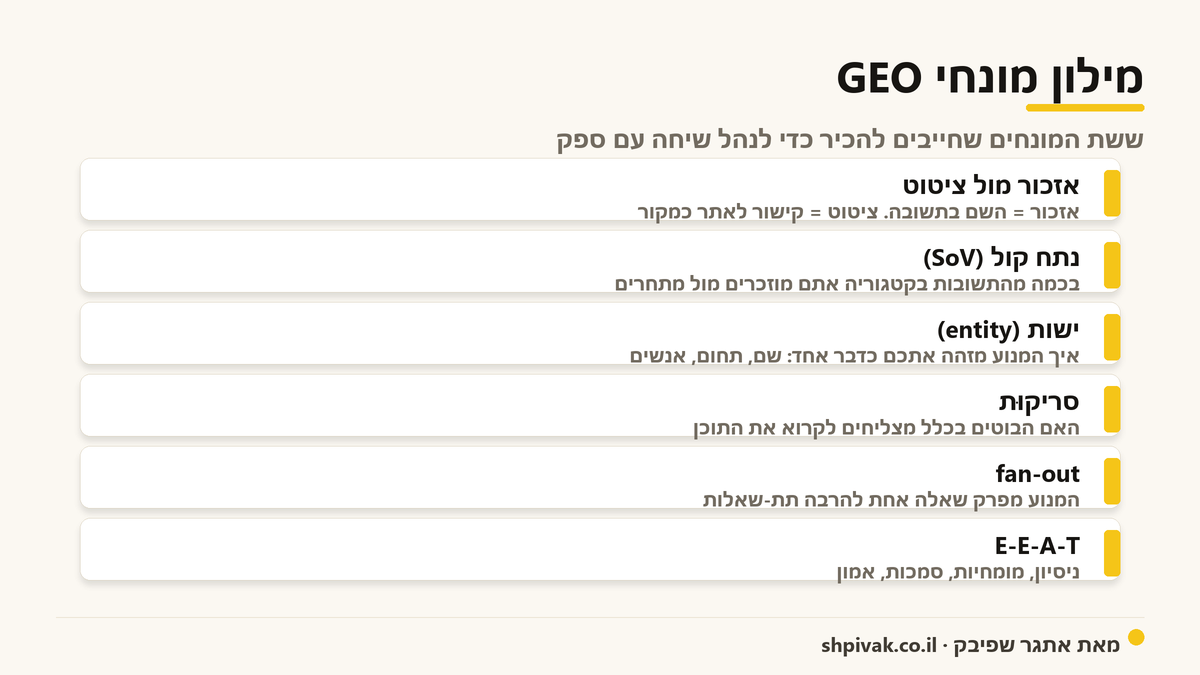
השפה: המושגים שחייבים להכיר
בלי להבין את המילים, אי אפשר לנהל שיחה מקצועית עם ספק. הנה המינימום, בעברית פשוטה:
- ציטוט מול אזכור (citation vs mention). אזכור הוא כשהמנוע מזכיר את השם שלכם בגוף התשובה. ציטוט הוא כשהוא מקשר לאתר שלכם כמקור. שני דברים שונים שצריך למדוד בנפרד.
- נתח קול (Share of Voice). מתוך כל התשובות בקטגוריה שלכם, בכמה מהן אתם מוזכרים מול המתחרים. זה אחד המדדים החשובים ביותר.
- ישות (entity). איך המנוע מבין מי אתם: השם, התחום, המייסדים, המתחרים. שתי דוגמאות כדי שיהיה ברור: כשאתם כותבים "אפל", המנוע צריך לדעת אם הכוונה לחברת הטכנולוגיה או לפרי, וזה נקבע לפי ההקשר והקישורים שמסביב. וכשכתוב "אתגר שפיבק", הישות מחברת בין השם, התפקיד באונו, והפעילות בשיווק, לכדי אדם אחד מזוהה. מותג עם ישות ברורה ועקבית קל יותר לזיהוי.
- סריקוּת (crawlability). האם הבוטים של מנועי ה-AI בכלל מצליחים להגיע לתוכן שלכם ולקרוא אותו.
- fan-out. גוגל, ChatGPT ומנועי בינה מלאכותית אחרים מפרקים שאלה אחת להרבה תת-שאלות ומחפשים תשובה לכל אחת. נרחיב על זה בחלק השלישי, אבל חשוב שתכירו את המילה.
- E-E-A-T. ניסיון, מומחיות, סמכות ואמון (Experience, Expertise, Authoritativeness, Trust). מסגרת של גוגל להערכת אמינות התוכן. אמון הוא החשוב ביותר בה.
אם ספק זורק עליכם את המילים האלה בלי להסביר, זה עצמו דגל. איש GEO טוב יודע לתרגם את המקצוע לשפה שמנהל מבין.
הבדיקה שעושים לפני שמתחילים
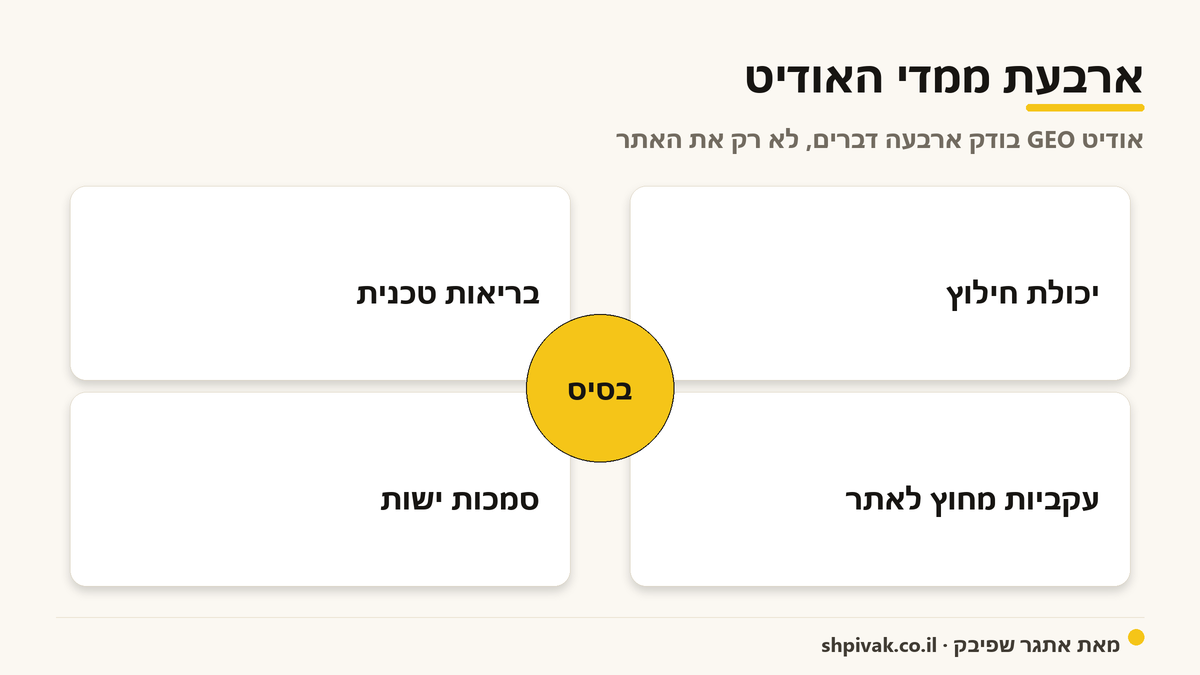
אסור להתחיל תהליך GEO בלי לצלם את נקודת ההתחלה. בלי בסיס, אי אפשר יהיה לדעת אם משהו השתפר. אודיט התחלתי טוב בודק ארבעה ממדים (Discovered Labs, יולי 2026):
- בריאות טכנית (האם הבוטים מגיעים, והאם יש דאטה מובנה, מידע מתויג שהמכונה יודעת לקרוא)
- יכולת חילוץ (האם התוכן בנוי כך שאפשר לשלוף ממנו פסקה נקייה)
- סמכות ישות (האם המנוע מזהה אתכם)
- עקביות מחוץ לאתר (האם מה שכתוב עליכם ברשת נכון ועקבי).
הבסיס מיתרגם לשלושה מספרים שמודדים לפני שמתחילים, ושלושתם באמת שונים זה מזה.
שיעור אזכור הוא באיזה אחוז מהתשובות המנוע בכלל הזכיר את השם שלכם.
שיעור ציטוט הוא באיזה אחוז מהן הוא גם קישר לאתר שלכם כמקור. לרוב הוא נמוך משיעור האזכור, כי אפשר להזכיר מותג בלי לקשר אליו (ולעיתים גם ההפך, קישור בלי אזכור שם).
נתח קול הוא כמה מהאזכורים בקטגוריה שייכים לכם לעומת המתחרים, כלומר מי מוביל בשיחה. דוגמה: מתוך 50 שאלות מפתח הוזכרתם ב-15 וקושרתם רק ב-5, אז שיעור האזכור הוא 30% ושיעור הציטוט 10%. אם באותן שאלות המתחרה הוזכר 30 פעם ואתם 15, נתח הקול שלכם הוא שליש.
חשוב: אלה חייבות להיות שאלות שבאמת רלוונטיות לעסק שלכם, לא שאלות כלליות שנשמעות טוב בדוח.
נקודה שאיש GEO מנוסה יזכיר לכם: המדידה היא מדגם, לא מדע מדויק. תשובות ה-AI לא דטרמיניסטיות, אז מודדים קבוצת שאלות קבועה שוב ושוב ולא מנסים לתפוס כל תשובה אפשרית (LLM Pulse, מאי 2026).
כרטיס ניקוד מוכנות GEO
מה עושה: שאלון בדיקה עצמית של כ-20 סעיפים בשש קטגוריות (גישת סורקים, דאטה מובנה, יכולת חילוץ, סמכות ישות, מדידה, ומותג ו-off-site), שמפיק כיסוי לפי ממד (ירוק/צהוב/אדום) ושלושת הפערים הכי דחופים. קלט: תשובות כן/חלקי/לא. פלט: כיסוי לפי קטגוריה ורשימת פעולות. אפשר לייצא את התוצאה לקובץ אקסל או CSV. הנתונים נשמרים מקומית בדפדפן כדי לראות התקדמות בפעם הבאה.
מה לבקש מהספק, ומה נראה דוח טוב
שלושה תוצרים שאתם אמורים לקבל מספק GEO: דוח אודיט (נקודת ההתחלה), דוח המלצות (מה לעשות, לפי סדר עדיפויות), ודוח חודשי שוטף. הנה איך כל אחד נראה כשהוא נעשה נכון.
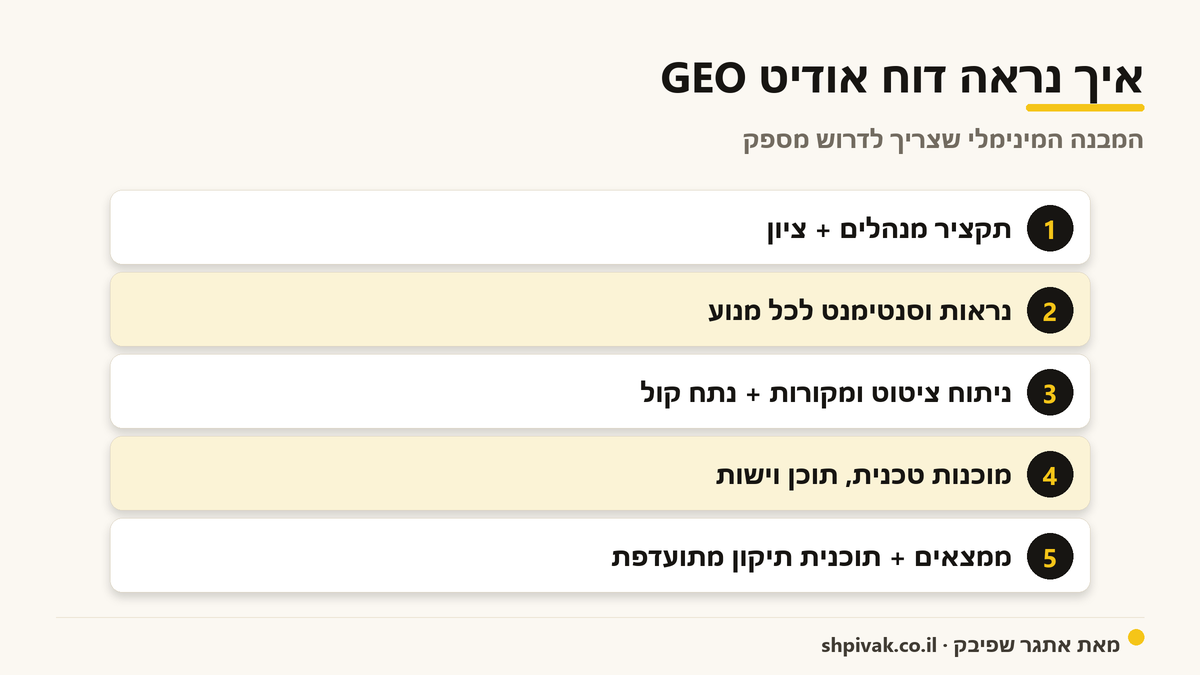
איך נראה דוח האודיט?
דוח האודיט, כפי שאני בונה אותו, כולל שישה עד תשעה חלקים: תקציר מנהלים (אם הספק נותן ציון כולל, דרשו לראות את המרכיבים שלו), נראות וסנטימנט לכל מנוע בנפרד, ניתוח ציטוט ומקורות (אילו דומיינים המנועים מצטטים בקטגוריה שלכם), נתח קול תחרותי, מבנה תוכן ומוכנות לציטוט, פערי דאטה מובנה, ישות ואמון, מוכנות טכנית, ולבסוף ממצאים ותוכנית תיקון מתועדפת עם הערכת מאמץ.
איך נראה דוח ההמלצות?
דוח ההמלצות מסודר לפי ארבעה עמודים (החלוקה שאני עובד לפיה, מקבילה לארבעת ממדי האודיט של Discovered Labs): טכני (האם הבוטים מוצאים ונגישים לתוכן), תוכן (האם ה-AI מבין ומחלץ), ישות (האם ה-AI מזהה מי אתם), וסמכות מותג (האם ה-AI סומך עליכם ומעדיף אתכם).
השניים הראשונים הם עבודת on-site (על האתר עצמו), השניים האחרונים בעיקר off-site (מחוץ לאתר). כל המלצה מקבלת ניקוד השפעה-מול-מאמץ, ומחולקת ל"נצחונות מהירים" מול "מפת דרכים".
איך נראה הדוח החודשי?
הדוח החודשי הוא המקום שבו רואים אם משלמים על עבודה אמיתית. מבנה נקי, בניסוח שלי, עונה על שלוש שאלות (רשימת המדדים לפי LLM Pulse, מאי 2026): איך אנחנו (נתח קול לכל מנוע, מיקום ממוצע, שיעור דיוק, מול החודש הקודם ומול הבסיס), איך מול המתחרים (פער נתח קול מול שניים-שלושה מתחרים) ומה קורה (מקורות מצטטים חדשים, שיפורי מיקום, הזיות שזוהו). והכי חשוב, מעקב ציטוטים: אילו עמודים ספציפיים שלכם ה-AI מקשר אליהם כמקור. זה התוצר שמוכיח שהעבודה קרתה.
נתי אלימלך, לשעבר ראש ה-SEO והנגישות ב-Wix ומנכ"ל SEO ישראל, והיום יועץ GEO ו-SEO טכני עצמאי, ממקד את המדידה בשלושה מסלולים שכדאי לבקש מהספק שיפריד ביניהם: מצוטט (עם קישור), מוזכר (בשם, בלי קישור) ודיוק המסר (מה ה-AI בעצם טוען עליכם). ההבחנה הזו מונעת דוחות שמערבבים בין "הזכירו אותנו" ל"קישרו אלינו" (המדריך שלו).
מה בודקים באופן שוטף ואיך מציבים יעדים
כאן שני ספקים ממליצים על קצבים שונים. GenOptima ממליצה לעקוב אחרי המדדים המובילים (ציטוט, אזכור, מיקום) בקצב שבועי. Analyticahouse בונה מודל דיווח חודשי. ההיגיון הסטטיסטי פשוט: תשובות ה-AI תנודתיות, אז דוגמים לעיתים קרובות אבל מחליטים לאט, כדי לא להגיב לרעש.
הפשרה שאני ממליץ עליה: להסתכל על המדדים המובילים בקצב שבועי או דו-שבועי כדי לדעת מה קורה, אבל לקבל החלטות ולדווח פעם בחודש, עם איפוס אסטרטגי רבעוני. מה שבטוח: אם ספק מדווח לכם בקצב של פחות מפעם בחודש, זה דגל אדום.
לגבי יעדים, צריך להפריד בין מדדים מובילים למדדי תוצאה. מדדים מובילים זזים מהר ומראים אם אתם בכיוון, עוד לפני שיש כסף: שיעור אזכור, שיעור ציטוט והמיקום שלכם בתוך התשובה. מדדי תוצאה (lagging) הם התוצאה העסקית עצמה, והם זזים לאט. שלוש דוגמאות קונקרטיות: כמה תנועה הגיעה לאתר ממנועי ה-AI, כמה מהמבקרים האלה הפכו ללקוחות משלמים ובכמה עלה מספר האנשים שמחפשים את שם המותג שלכם בגוגל.
הקשר בין השניים: אחרי חודשיים כבר רואים שהוזכרתם ביותר תשובות (מדד מוביל עולה), אבל רק אחרי חצי שנה זה מתחיל להיתרגם לעוד פניות מכירה (מדד תוצאה). ציפיות ריאליות (הערכה מקובלת אצל ספקים, לא נתון נמדד): בחודשים הראשונים ציטוטים ראשונים, סביב שלושה חודשים גידול משמעותי בשיעור הציטוט, ורק אחרי שישה חודשים ומעלה קורלציה יציבה בין ציטוטי AI לעלייה בחיפושי המותג.
נתי אלימלך מציע עדשה משלימה למעקב, לא לפי שלב במשפך אלא לפי סוג הפרומפט שהלקוח מקליד (הפוסט שלו): פרומפט המלצה (מבקש רשימת אפשרויות בלי לנקוב במותג, "אילו כלים שווה לבדוק"), פרומפט השוואה (בין אפשרויות ידועות או חיפוש אלטרנטיבה) ופרומפט אימות (בדיקת פרט לפני פעולה: מחיר, שעות, מגבלה טכנית, וכאן ה-AI הכי חשוף לטעות כי הידע שלו מיושן). הכלל שלו למדידה: כל פרומפט נמדד לפחות עשר פעמים מחשבונות נקיים בלי שכבת זיכרון, כי תשובה בודדת היא אנקדוטה, לא נתון.
מחשבון נתח קול ב-AI
מה עושה: מזינים כמה פעמים אתם והמתחרים הוזכרתם על פני קבוצת שאלות, והכלי מחשב נתח קול באחוזים, מפריד בין אזכור לציטוט, ומצייר גרף. קלט: ספירות אזכור/ציטוט לכם ולמתחרים. פלט: נתח קול, שיעור אזכור מול ציטוט, גרף. אפשר לייצא לקובץ אקסל או CSV. הכול נשמר מקומית.
תבנית לוח מחוונים (KPI) ל-GEO
מה עושה: לוח פשוט לעקוב חודש אחר חודש אחרי תעבורת AI, נתח קול, מספר שאלות שמצטטות אתכם, ויחס ממותג מול לא-ממותג. קלט: נתונים חודשיים ידניים (מועתקים מ-GA4, מערכת האנליטיקס של גוגל, ומהכלים הקודמים). פלט: כרטיסי KPI עם השינוי מהחודש הקודם, ייצוא לקובץ אקסל או CSV. אחסון מקומי.
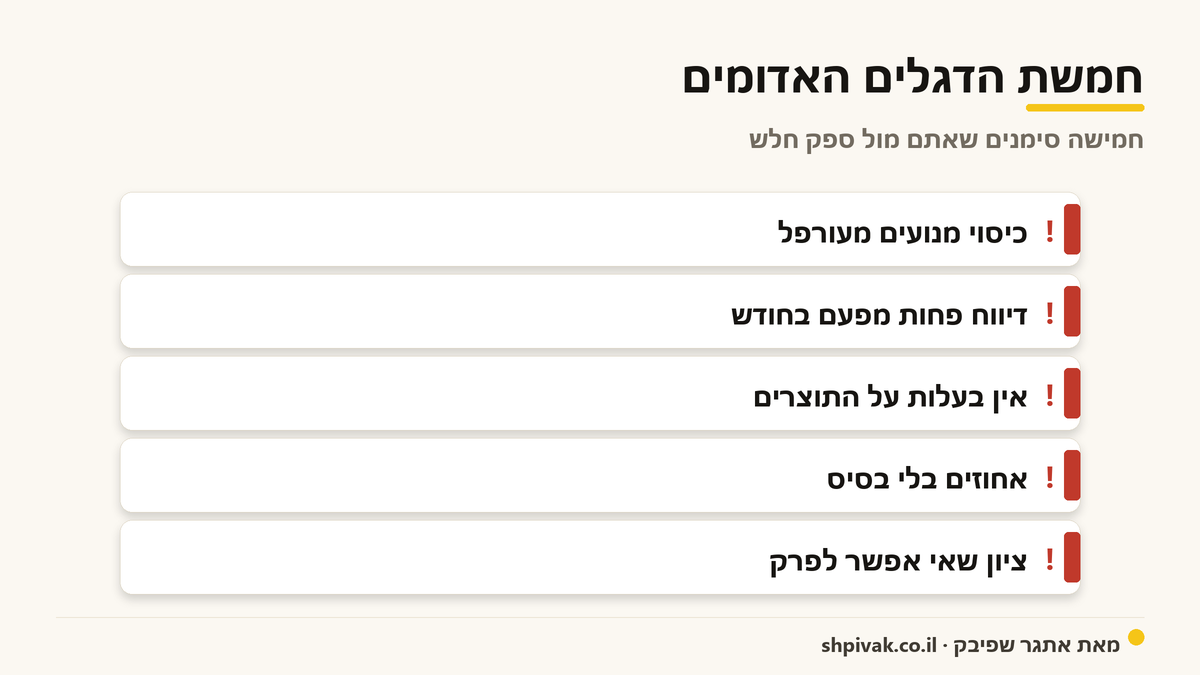
דגלים אדומים: איך מזהים ספק גרוע
זה החלק שיחסוך לכם כסף. הנה הסימנים שספק לא באמת יודע מה הוא עושה (בהשראת פוסט של Influencers-Time, ספטמבר 2026, אתר תוכן שיווקי ולא מחקר, ומניסיוני):
- כיסוי מנועים מעורפל. אם הוא אומר "כל הפלטפורמות המובילות" בלי לנקוב בשמות, זה חשוד. ספק טוב נוקב בפלטפורמות הרלוונטיות עבורכם: ChatGPT, Perplexity, Gemini, AI Overviews, Copilot, Claude.
- דיווח בקצב של פחות מפעם בחודש.
- בעלות על התוצרים. מה קורה עם התכנים שהספק יצר מחוץ לאתר, והאם היסטוריית הציטוטים נשארת שלכם אם אתם עוזבים?
- מקרי בוחן באחוזים בלי בסיס. "עלייה של 50%" שהיא בעצם מ-2 ל-3 ציטוטים היא לא אותו סיפור כמו 50% מ-2,000.
- ציון "נראות" מורכב שאי אפשר לפרק אותו.
הסימן הכי אמין, לדעתי: ספק חלש לא יכול להראות לכם את השאלות המדויקות שהוא עוקב אחריהן, ולא יכול לנקוב בציטוט חדש וספציפי אחד שהוא זכה בו ב-30 הימים האחרונים. עבודה אמיתית משאירה עקבות שאפשר לראות.
דוגמה מלאה: GEO על מותג אחד, מהאודיט לתוצאה
עד כאן הרכיבים. הנה איך הם מתחברים על מותג אחד. ניקח דוגמה בדיונית: "נובופיי", כלי סליקה לעסקים קטנים.
נקודת ההתחלה (אודיט). מריצים 50 שאלות מפתח על פני חמישה מנועים. נובופיי מוזכר ב-20% מהתשובות, מצוטט (עם קישור) ב-6% בלבד, ונתח הקול שלו מול שני מתחרים הוא כשליש על פני כל המאגר, ונמוך מזה בשאלות ההשוואה, שם המאבק האמיתי. הבוט של OpenAI מקבל 200 (קוד "הכול תקין") על האתר, אבל דף המחירים מרונדר רק בצד הלקוח (נבנה בדפדפן ולא מגיע מוכן מהשרת), אז הוא בלתי נראה לשליפה.
שלוש הפעולות שנבחרו (לפי סדר הביצוע). ראשית, לתקן את הרינדור כך שהתוכן המרכזי מגיע ב-HTML הראשוני, ולוודא אינדוקס ב-Bing (שהאתר ייכלל במאגר החיפוש של Bing). שנית, לכתוב שלושה עמודי השוואה שעונים על שאלות הקנייה האמיתיות ("נובופיי מול X"), כל אחד עם תשובה ישירה בפתיחה ודאטה מקורי. שלישית, לזכות בשלוש כתבות במקורות חיצוניים (earned media) ולפרסם תמלול של וובינר על דומיין משלו.
מה זז (שבועות 6 עד 12, מספרים להמחשה). שיעור הציטוט עלה מ-6% ל-14%, נתח הקול בשאלות ההשוואה חצה חצי מול המתחרים, וחיפושי המותג "נובופיי" בגוגל התחילו לטפס. שום דבר מזה לא קרה בשבוע הראשון, והכול נמדד מול הבסיס שצולם באודיט.
חלק שלישי: לאנשי המקצוע. הבשר של ה-GEO
מכאן זה טכני יותר, אבל כתבתי את זה בהנחה שאתם לא מומחי GEO, אלא אנשי שיווק שרוצים להיות כאלה. כל מונח מוסבר. יש קטעים ברמה בסיסית ויש קטעים טכניים ממש, וזה בסדר. המטרה היא שתסיימו את החלק הזה ותוכלו לעשות GEO בעצמכם.
איך עושים אודיט GEO
אודיט אמיתי הוא לא צילום מסך אחד של ChatGPT. הוא הערכה חוזרת וניתנת לשחזור של איך המותג מופיע בתשובות, על פני כמה מנועים. הסיבה: תשובות ה-AI לא דטרמיניסטיות, ותמהיל הציטוטים משתנה בפראות. אודיט של הרצה בודדת פשוט לא אמין.
הצעד הראשון: מאגר שאלות קבוע
בונים קבוצה קבועה של 30 עד 100 שאלות, מפולחות לפי הסוגים שהכרנו: שאלות כלליות, שאלות מחקר, שאלות מותג, שאלות השוואה. מריצים אותן על פני ChatGPT, Perplexity, ה-AI Overviews של גוגל, Gemini ו-Copilot, כל אחת כמה פעמים. לכל תשובה רושמים: האם הוזכרנו, האם צוטטנו, אילו מתחרים הופיעו, ומאילו מקורות המנוע שאב.
מאיפה לוקחים את השאלות? לא ממציאים אותן מהראש, אלא אוספים מהמקומות שבהם לקוחות אמיתיים כבר שואלים.
שישה מקורות:
- שאלות שחוזרות בשיחות מכירה ובטיקטים של תמיכה
- ה"אנשים גם שואלים" (People Also Ask) שמופיע בתחתית תוצאות גוגל על מילות המפתח שלכם
- כלים כמו AlsoAsked ו-AnswerThePublic שממפים שאלות שנשאלות סביב נושא
- דיונים אמיתיים ב-Reddit וב-Quora בתחום שלכם
- שאלות ההשוואה מול המתחרים ("X מול Y", "אלטרנטיבה ל-Z")
- ולבסוף, פשוט לשאול את ChatGPT ו-Perplexity "מה אנשים שואלים כשהם שוקלים לקנות בקטגוריה הזו", ולראות אילו שאלות הם עצמם מציעים.
מכל אלה בוחרים את השאלות שבאמת רלוונטיות לעסק, ומקבעים אותן כרשימה שרצה שוב ושוב.
אנידור חקק, מייסד ומנכ"ל היידה דיגיטל ומרצה לקידום אתרים ושיווק דיגיטלי בקריה האקדמית אונו (ולאחרונה גם GEO), מציע מתודולוגיה נקייה בחמישה שלבים שאפשר לאמץ (המדריך שלו): אודיט נוכחות ב-AI, יישור ישות וסמכות, בניית "יחידות תשובה" ראויות לציטוט עם דאטה מקורי, שכבת off-site ומעקב ציטוט שבועי על מאגר שאלות קבוע.
הסורקים: מי בכלל מגיע לתוכן שלכם
נקודה טכנית שמבדילה אודיט טוב: הסורקים. יש שלוש משפחות בוט, לא שתיים: בוט אימון שאוסף תוכן כדי לאמן את המודל, בוט אינדוקס לחיפוש שבונה את מאגר החיפוש של המנוע, וfetcher שמופעל על ידי משתמש שמביא עמוד בזמן אמת כשמשתמש מבקש.
נקודה קריטית: robots.txt הוא בקשה, לא חומה. הוא שולט על אימון ואינדוקס, אבל fetchers שמופעלים על ידי משתמש (ChatGPT-User, Perplexity-User) לרוב לא מצייתים לו. אפשר גם בטעות לחסום את בוט האינדוקס, ואז אתם פשוט לא קיימים בתשובות. הנה מי מול מי:
| חברה | בוט אימון | בוט אינדוקס לחיפוש | fetcher (מופעל משתמש) |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Perplexity | (אין נפרד) | PerplexityBot | Perplexity-User |
| Google-Extended (אימון + grounding ב-Gemini) | Googlebot (חיפוש + AI Overviews) | (אין) | |
| Microsoft | (אין נפרד) | Bingbot | (אין) |
| Meta / Apple / Common Crawl | Meta-ExternalAgent, Applebot-Extended, CCBot | (אין) | (אין) |
הניואנס הכי חשוב בגוגל: ה-AI Overviews וה-AI Mode מוגשים מאינדקס החיפוש הרגיל ומשתמשים ב-Googlebot, לא בבוט AI ייעודי. חסימת Google-Extended לא מוציאה אתכם מ-Overviews, אבל היא כן מוציאה אתכם גם מהאימון וגם מה-grounding של אפליקציית Gemini, המנוע השני בגודלו. מי שרוצה להופיע ב-Gemini לא חוסם אותה. לעומת זאת חסימת Googlebot מוציאה אתכם מהכול.
נתי אלימלך פירסם מדריך ממצה לבוטים של OpenAI (המדריך), ומשם נקודה שחוסכת טעות יקרה: כל בוט מציית רק לקבוצת הכללים הכי ספציפית שמתאימה לו ב-robots.txt. אם חסמתם הכול עם User-agent: * ופתחתם במפורש רק ל-Googlebot, בוטי ה-AI (שאין להם כלל ייעודי משלהם) נופלים תחת הכלל הכללי החוסם, וחסמתם אותם בלי לשים לב. נתי מציין שעל אתרים ישראליים רבים הבוטים של OpenAI לבדם הם כשליש מכלל תעבורת הבוטים.
בודק גישת סורקי-AI ומחולל robots.txt
מה עושה: מדביקים את קובץ ה-robots.txt שלכם (או מתחילים מאפס), והכלי מראה טבלה של אילו בוטי AI מורשים ואילו חסומים, ומחולל קובץ תקין לפי העמדה שבחרתם (לאפשר תשובות, לחסום אימון, לחסום הכול). קלט: תוכן robots.txt + בחירת עמדה. פלט: טבלת בוטים + קובץ מוכן להורדה + אזהרות בשפה פשוטה (כולל התזכורת ש-fetchers שמופעלים על ידי משתמש לרוב לא מצייתים ל-robots.txt, אז "לחסום הכול" לא באמת חוסם הכול). הכול רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור, כי הכלי לא ניגש לאתר שלכם, אתם מדביקים את הקובץ.
צ'קליסט אודיט GEO
מה עושה: צ'קליסט אינטראקטיבי שעובר על כל שלבי האודיט (הגדרת מאגר שאלות, הרצות בסיס על פני כל המנועים, ניקוד אזכור/ציטוט/נתח קול/סנטימנט, ניתוח מקורות, בדיקת סריקוּת, on-page ודאטה מובנה, ישות מחוץ לאתר, פער תחרותי, וממצאים מתועדפים), מסמן מה הושלם, ומפיק דוח. קלט: סימון סעיפים. פלט: אחוז השלמה, רשימת פערים, וייצוא לקובץ אקסל או CSV. אחסון מקומי.
ההבדל בין המנועים המרכזיים
כל מנוע שולף ומצטט אחרת, אז אסור להריץ אסטרטגיה אחת לכולם, ואסור למצע נתונים בין מנועים. שלוש נקודות שמשנות תכנון:
- ChatGPT התחיל על האינדקס של Bing, אבל זה משתנה. מחקר קטן של Seer Interactive (פברואר 2025, 100 שאילתות על SearchGPT) מצא ש-87% מהציטוטים תאמו לתוצאות המובילות ב-Bing, לעומת כ-56% בגוגל. אבל ב-2026 ChatGPT כבר בנה אינדקס משלו (Peec AI, ספטמבר 2026), דרך הסורק OAI-SearchBot ולצד ספקי תוצאות חיצוניים, ו-Bing נשאר בעיקר ב-Deep Research. המסקנה המעשית: אל תחסמו את OAI-SearchBot, וודאו אינדוקס ב-Bing כרשת ביטחון. ל-Copilot, Bing עדיין המנוע. זה דבר שרוב אנשי השיווק בישראל בכלל לא נוגעים בו.
- גוגל עובדת ב-fan-out. השאילתה מפורקת לתת-שאלות מקבילות, כל אחת שולפת ומדרגת מקורות בנפרד, ו-Gemini מסנתז. לכן עמוד שמדורג במקום השישי אבל עונה מצוין על תת-שאלה יכול להיות מצוטט. כאן כיסוי נושאי ופסקאות מנצחים דירוג לבדו.
- Perplexity הכי צפוף בציטוטים ותמיד שולף חי. כל טענה ממופה להערת שוליים ממוספרת, וטריות וסמכות המקור מנצחות שם.
הפועל היוצא: אנידור חקק ממליץ על פלייבוק לכל מנוע (ChatGPT: סמכות דומיין וטריות; Perplexity: דאטה צפוף ומחקר מקורי; Gemini: להישען על האקוסיסטם של גוגל ועל ה-SEO הקיים; Copilot: אינדקס Bing; ו-AI Mode: לכסות את כל עץ ה-fan-out). אל תניחו שמה שעובד באחד עובד בכולם.
איך מופיעים בצ'אט GPT (ChatGPT)?
התשובות של ChatGPT עם חיפוש נשענות על עמודים שהסורק OAI-SearchBot קרא. בתיעוד הסורקים של OpenAI כתוב שאתר שחסם את הבוט הזה לא יופיע בתשובות החיפוש של ChatGPT, לכל היותר כקישור ניווט, ושלוקח כ-24 שעות עד ששינוי ב-robots.txt נקלט.
מה עושים: פותחים בדפדפן את yoursite.co.il/robots.txt (או מדביקים אותו בבודק שלמעלה) ומוודאים ששום כלל לא חוסם את OAI-SearchBot. אחר כך שואלים את ChatGPT, עם חיפוש פעיל, שלוש שאלות על המותג ובודקים אילו עמודים שלכם הוא מצטט.
איך מופיעים ב-AI Overviews וב-AI Mode של גוגל?
אלה שני מקומות שונים שיושבים על אותו אינדקס. AI Overviews הוא הסיכום שגוגל מציגה מעל התוצאות הרגילות, ורק כשהיא מעריכה שהוא מוסיף משהו. AI Mode הוא המצב הנפרד לשאלות ארוכות ולהשוואות, ושניהם עשויים לרוץ על מודלים שונים, ולכן גם הקישורים שהם מציגים שונים. בתיעוד של גוגל יש תנאי אחד לשניהם: העמוד צריך להיות מאונדקס וכשיר להופיע בחיפוש עם snippet (קטע התקציר שמתחת לכותרת), ואין קובץ או markup נוסף שצריך להוסיף.
מה עושים: מכניסים את העמוד הכי חשוב שלכם לכלי בדיקת ה-URL ב-Search Console ומוודאים שהוא מאונדקס. אם הוא מאונדקס ועדיין לא מופיע אף פעם, שואלים את המפתח אם תגית nosnippet או max-snippet מגבילה אותו.
איך גורמים ל-Perplexity לצטט אתכם?
כל שאלה ב-Perplexity מפעילה חיפוש חי ברשת, וכל טענה בתשובה מקבלת הערת שוליים, ולכן הוא יכול לצטט רק עמוד שהבוט PerplexityBot מורשה להגיע אליו. בתיעוד הסורקים של Perplexity יש אזהרה: אתר שיושב מאחורי WAF (שכבת האבטחה שעומדת לפני אתרים רבים, למשל זו של Cloudflare) עשוי להזדקק לכלל מפורש שמכניס את הבוטים שלו.
מה עושים: מבקשים ממי שמנהל אצלכם את Cloudflare או את האחסון לוודא ש-PerplexityBot מורשה. אחר כך שואלים את Perplexity שאלה אחת שהעמוד שלכם עונה עליה ובודקים אם אתם בהערות השוליים.
איך מופיעים בתשובות של Claude?
ל-Anthropic יש שלושה בוטים, והבוט שמאנדקס את העמודים שלכם בשביל החיפוש של Claude הוא Claude-SearchBot. במאמר העזרה של Anthropic כתוב שחסימה שלו עלולה לפגוע בנראות ובדיוק של האתר בתוצאות החיפוש, ושהבוטים של החברה לא מנסים לעקוף CAPTCHA. כלומר, מסך אימות שהאתר מציג לבוטים (bot challenge) משאיר את Claude בחוץ בדיוק כמו חסימה ב-robots.txt.
מה עושים: מאשרים ב-robots.txt את Claude-SearchBot ואת Claude-User, ומוודאים שהגנת הבוטים באתר לא מציגה להם מסך אימות.
איך מופיעים ב-Copilot של מיקרוסופט?
התשובות של Copilot מגיעות מהאינדקס של Bing, ולכן העבודה מתחילה ב-Bing Webmaster Tools, שהוא חינמי. דוח ה-AI Performance שבו מראה איך העמודים שלכם מופיעים בתשובות AI ב-Copilot וב-Bing, וביוני 2026 מיקרוסופט הוסיפה לו בגרסת preview פילוח לפי כוונת החיפוש, פילוח לפי נושא ונתח ציטוטים מול מקורות אחרים.
מה עושים: מאמתים את האתר ב-Bing Webmaster Tools, מגישים את ה-sitemap ובודקים פעם בחודש אילו עמודים הפסיקו להיות מצוטטים.
On-site: איך בונים דף שנשלף ומצוטט
הרבה ממה שעשיתם ל-SEO עדיין רלוונטי מאוד ל-GEO. תוכן ברור, מבנה נקי, אתר מהיר ונגיש לסורקים, כל אלה נשארים. GEO לא מחליף את זה, הוא מגיע כשכבה נוספת מעליו. אז אל תזרקו את מה שעבד, פשוט הוסיפו עליו. הנה מה שבאמת שונה.
למה היחידה שנשלפת היא הפסקה, לא הדף?
מנוע ששולף בזמן אמת לא "קורא את הדף שלכם" מההתחלה לסוף. הוא מחפש (ב-Bing, בגוגל או באינדקס שלו), מביא עמודים, ומשתמש רק בפסקאות שעונות על תת-השאלה. מערכות רבות עובדות על מקטעי תוכן (chunks), לא על מסמך שלם. המסקנה, שגם נתי אלימלך מנסח: היחידה שנשלפת ומצוטטת היא הפסקה, לא הדף. שפטו כל החלטה בדף לפי השאלה "איך הפסקה הזו נקראת בפני עצמה, מנותקת מכל מה שסביבה" (כלל אצבע נוח: פסקה קצרה שעומדת לבד).
נתי אלימלך מנסח את זה חד: "יחידת המידע היא הפסקה, לא העמוד". אופטימיזציה נכונה היא לבהירות ברמת הפסקה העצמאית, לא לדירוג ברמת המסמך.
איך כותבים פסקה שנשלפת?
מתחת לכל כותרת, פתחו במשפט שעונה על השאלה במלואה, בפסקה קצרה אחת (כלל אצבע של התחום, בערך 40-60 מילה, לא סף רשמי), לפני כל הקדמה. משפטים עצמאיים, בלי כינויי גוף שמצביעים החוצה ("זה", "כפי שראינו למעלה"). כותרות בצורת שאלה. עובדות ומספרים עם ייחוס למקור. פורמט מנצח לפי סוג השאלה: השוואה בטבלה, תהליך ברשימה ממוספרת, מונחים ברשימת הגדרות.
הפורמט הוא שער לשליפה שקודם למילות מפתח. ובאמת, רוב ה-AI Overviews מכילים לפחות רשימה אחת, ושורות סטטיסטיקה וטבלה נשאבות הכי הרבה, כי אי אפשר לנסח מספר מחדש בבטחה.
מנתח "תשובה קודם" ויכולת ציטוט
מה עושה: מדביקים פסקה, והכלי נותן ציון: האם התשובה במשפט הראשון? האם היא באורך של 40-60 מילה (כלל אצבע, לא סף שנמדד)? עצמאית? מכילה מספר או נתון? ומציע שיפורים. קלט: פסקה או קטע. פלט: ציון + צ'קליסט + הצעות ניסוח. הכול רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
רינדור: איך אתרים נעלמים בשקט?
Vercel ו-MERJ ניתחו (המחקר המכונן בתחום, דצמבר 2024, ועדיין תקף) 569 מיליון בקשות של GPTBot ומצאו אפס הרצת JavaScript. הבוטים של OpenAI, Anthropic ו-Perplexity שולפים HTML גולמי בלבד. חשוב לדעת: Gemini וה-AI Overviews של גוגל כן מרנדרים JavaScript דרך התשתית של Googlebot. המשמעות: אם התוכן שלכם מרונדר רק בצד הלקוח (CSR, Client-Side Rendering, כלומר ה-JavaScript בונה את הדף אצל הגולש), הוא בלתי נראה ל-ChatGPT, ל-Claude ול-Perplexity. הגשה של ה-HTML המרכזי מהשרת (SSR או HTML סטטי) פותרת את זה.
נתי אלימלך עשה כאן ניסוי (פורסם במרץ 2026, עודכן בספטמבר 2026): הוא בנה עמודים זהים עם דאטה בדיוני על פלטפורמות בניית האתרים המבוססות AI (Lovable, Base44, Bolt, v0), ובדק אם ChatGPT ו-Claude מצליחים לקרוא אותם. התוצאה: תוכן הגוף עלה רק כשהפלטפורמה הגישה HTML אמיתי. פלטפורמות שהחזירו div ריק פשוט נכשלו (הניסוי המלא).
איך בודקים את זה בעצמכם, בלי לכתוב שורת קוד? הכי פשוט: קליק ימני על העמוד ובחירת "הצג מקור" (View Source, או Ctrl+U). זה מראה בדיוק את ה-HTML הגולמי שהבוט מקבל, לפני שה-JavaScript רץ. אל תשתמשו ב"בדוק אלמנט" (Inspect), כי הוא מציג את הדף אחרי שה-JavaScript בנה אותו, וזה לא מה שהבוט רואה. שימו לב שבוט לפעמים מקבל תגובה שונה מהדפדפן שלכם (למשל חסימת 403 של Cloudflare), אז אם יש לכם גישה ללוגי השרת, שם רואים מה הבוט באמת קיבל. כלי בדיקת ה-URL של Google Search Console מראה את ה-HTML אחרי רינדור של גוגל, כך שהוא מתאים לגוגל אבל לא משקף בהכרח את הבוטים האחרים. הכלל: אם התוכן המרכזי לא מופיע ב"הצג מקור", כנראה שהבוטים לא רואים אותו.
איך בונים מבנה קריא למכונה?
מעבר לרינדור, המבנה עצמו צריך להיות קריא למכונה. היררכיית כותרות נקייה (H1 אחד, H2 לנושאים, H3 לתת-נושאים), תגיות סמנטיות אמיתיות (article, section, nav) ולא רק div, וכל רעיון בפסקה משלו. ככל שהמבנה ברור יותר, קל יותר למנוע לחתוך אותו למקטעים נכונים ולשלוף את הפסקה הנכונה.
איך בונים עמוד GEO, שלב אחר שלב?
- מתחילים מהשאלה שהעמוד עונה עליה, לא ממילת מפתח.
- כותבים כותרת בצורת שאלה.
- פותחים בתשובה ישירה של 40-60 מילה.
- מוסיפים דאטה או סטטיסטיקה מיוחסת בשורה עצמאית.
- מפרקים לתת-נושאים עם כותרות משנה.
- בוחרים פורמט לפי סוג השאלה: טבלה להשוואה, רשימה לתהליך.
- מוסיפים בלוק שאלות נפוצות מהשאלות האמיתיות שעלו.
- מסמנים schema שתואם למה שגלוי על העמוד.
מהירות אתר וחוויית משתמש: הרבה מיתוסים
מהירות היא כרטיס כניסה, לא מנוף. צריך לדייק כאן, כי יש בזה שני חצאים שנשמעים סותרים ושניהם נכונים. מצד אחד, מחקר של Discovered Labs (אוגוסט 2026, כ-2 מיליון ציטוטים) מצא שאחרי שמנטרלים את חוזק הדומיין, ל-Core Web Vitals (מדדי המהירות והיציבות של גוגל) אין השפעה עצמאית על ציטוטים, אז מהירות טובה יותר לא קונה לכם ציטוטים. מצד שני, אתר איטי מדי כן פוגע: סורקי ה-AI לא ממתינים לעמוד איטי ועלולים לנטוש אותו לפני שקראו אותו. אין על כך מספר רשמי, אז הכלל המעשי פשוט: כוונו לזמן תגובת שרת (TTFB) מתחת ל-0.8 שניות (הסף של גוגל), ורצוי פחות, ושהתוכן המרכזי יגיע כבר ב-HTML הראשוני.
אחר כך תעצרו ותשקיעו את השאר בסמכות ובתוכן, לא בעוד שיפורי מהירות. וחוויית המשתמש? המנוע לא רואה את האנליטיקס שלכם, אז זמן שהייה ואחוז נטישה לא מזינים ציטוט. היא חשובה כדי להמיר את התעבורה שכבר זכיתם בה, לא כדי לזכות בציטוט.
Schema וישות: איפה באמת המנוף
Schema (דאטה מובנה) לא יוצר סמכות, הוא מסיר דו-משמעות כדי שהמכונה תדע בדיוק מי אתם. הערך הוא בעקביות: אותו שם ואותם פרטים בכל מקום, ומאפיין sameAs שמקשר את הישות שלכם באתר לפרופילים המזהים ברשת: Wikipedia, Wikidata, LinkedIn, Crunchbase. הסוגים שחשובים: Organization, Person (עם המחבר ואישוריו), Article, FAQPage.
כלל ברזל: ה-schema חייב להתאים למה שמופיע גלוי בעמוד, אחרת זו הפרת הנחיות.
איפה זה יושב בפועל: בלוק JSON-LD בתוך ה-<head> של העמוד (או ממש לפני סוף ה-<body>), לא משהו שהמבקר רואה על המסך.
ואיך בודקים אותו לבד, בלי לגעת בקוד: מדביקים את כתובת העמוד ב-Rich Results Test של גוגל, והכלי מראה אילו סוגי schema גוגל זיהתה בעמוד ואם יש בהם שגיאות. ותהיו כנים עם עצמכם: schema תקין הוא רף בסיס והיגיינה, לא ניצחון GEO. המנוף האמיתי הוא בהירות ישות, ורובו חינם.
מחולל סכימת Organization ו-Person
מה עושה: ממלאים טופס (שם, אתר, לוגו, תפקיד, רשימת sameAs), והכלי מייצר בלוק JSON-LD תקין (הפורמט שבו כותבים דאטה מובנה) להעתקה, עם התראה על שדות חסרים. קלט: פרטי הארגון/האדם + רשימת פרופילים. פלט: קוד schema מוכן. הכול רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
מחולל בלוק "עובדות מפתח" ושאלות נפוצות
מה עושה: מזינים זוגות שאלה-תשובה, והכלי מייצר גם HTML נקי לעמוד וגם סכימת FAQPage, עם התראה אם תשובה ארוכה מדי או בלי מספר. קלט: שאלות ותשובות. פלט: HTML + JSON-LD. הכול רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
Knowledge Panel ו-Wikidata, בלי לבלבל בין המושגים
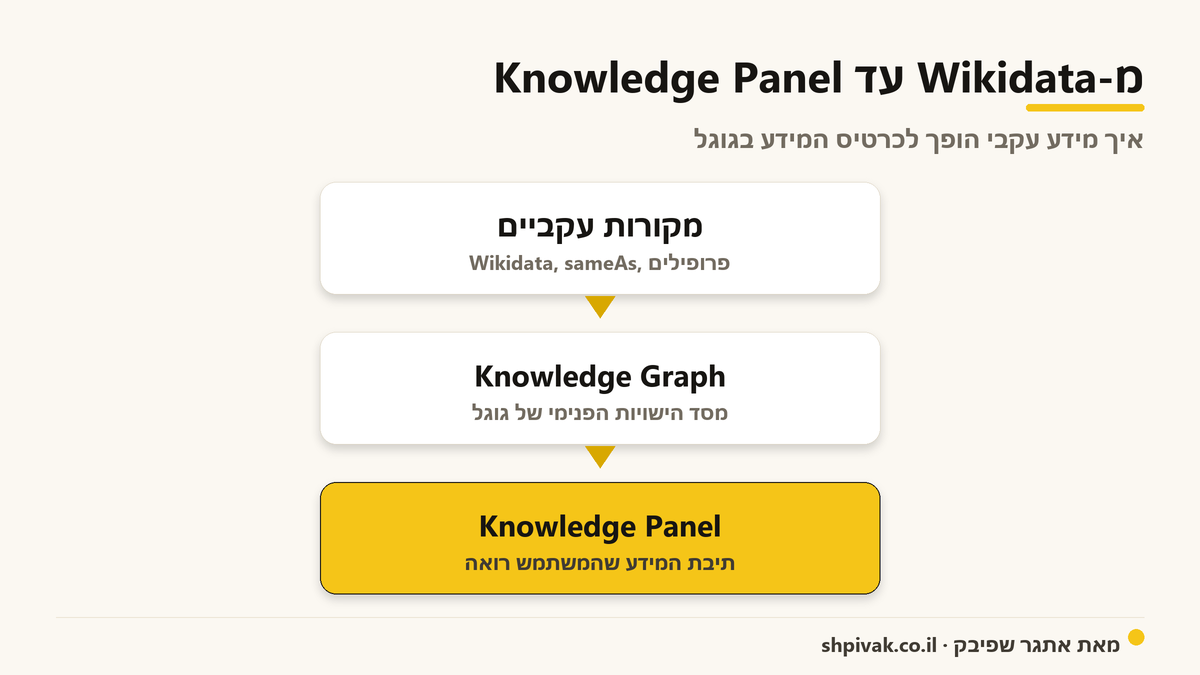
Knowledge Graph הוא מסד הנתונים הפנימי של גוגל על ישויות בעולם, המשתמש לא רואה אותו. Knowledge Panel הוא מה שכן רואים: תיבת המידע בצד עמוד התוצאות. Wikidata הוא מסד נתונים מובנה ופתוח שמזין את גרף הידע ונבלע על ידי ה-LLMs (מודלי השפה הגדולים שמאחורי מנועים כמו ChatGPT).
איך זה מתחבר: מקורות עקביים כמו Wikidata מזינים את גרף הידע של גוגל, וכשגוגל בטוחה מספיק במי אתם, היא מציגה עליכם Knowledge Panel.
נקודה שמפתיעה: ערך Wikipedia כבר לא חובה כדי לקבל פאנל, פריט Wikidata תקין יכול לתמוך. אבל הוא לא מייצר פאנל לבדו, והוא דורש notability: פריט שמותג יוצר על עצמו בלי מקורות חיצוניים רציניים (עיתונות, רשם חברות) נמחק.
מותר לערוך את הישות של עצמכם בתנאי שכל טענה נשענת על מקור חיצוני, ועריכה בתשלום חייבת גילוי. פאנל של עסק מקומי מקבלים קודם דרך Google Business Profile.
בודק עקביות ישות (NAP: שם, כתובת, טלפון)
מה עושה: מזינים את פרטי המותג כפי שהם מופיעים בכל מקור (שם בכל השפות והווריאציות, תיאור, קטגוריה, שנת הקמה, מייסדים, עיר, פרופילים), והכלי מסמן חוסר עקביות שמבלבל את המנוע. שם, כתובת וטלפון (NAP) חשובים בעיקר לעסקים מקומיים. קלט: אותם שדות מכל מקור. פלט: הדגשת אי-התאמות + הצעת גרסה קנונית. הכול רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
Off-site: להפוך לשם שהמנוע ממליץ עליו
חלק גדול מעבודת ה-GEO קורה מחוץ לאתר שלכם. המנוע שואל "מי אמין ומה הקונצנזוס עליו", ופותר את זה באמצעות מה שהרשת אומרת עליכם.
מה אומרים המספרים של 2026?
Muck Rack (מאי 2026, 25 מיליון קישורים): 84% מהציטוטים של ה-AI מגיעים ממה שאחרים אומרים עליכם (מקורות צד שלישי שהרווחתם בזכות התוכן והמוניטין, בעיקר עיתונות אבל גם אקדמיה, ממשל ו-Wikipedia, לא פרסום ששילמתם עליו), ורק 0.3% מפרסום ממומן.
Ahrefs (כ-75,000 מותגים, מאי ודצמבר 2025): אזכורי מותג ברשת מתואמים הרבה יותר חזק עם נראות ב-AI מקישורים נכנסים (מתאם, לא סיבתיות), ו-Stacker עם Scrunch (מרץ 2026, מחקר של ספק ההפצה עצמו על 30 מותגים): הפצה דרך אתרי צד שלישי הביאה עלייה חציונית של 239% בציטוטים, לעומת אותו תוכן על האתר שלכם בלבד.
הכלל: הדומיין שאומר את זה עליכם חשוב יותר מהמילים.
יש כאן גם ראיה כנה שמצריכה זהירות. ניסויים של Zeeshan Yaseen ב-Search Engine Land (ספטמבר 2026) מצאו שרשימות "הכי טוב" שמותג פרסם על עצמו תרמו רק 14% מהציטוטים, בעוד השמות בצד שלישי הביאו כמעט 86% מהציטוטים. וגם: כמחצית מהמקורות הפסיקו להיות מצוטטים תוך 30 יום. פרסום חד-פעמי לא מחזיק. המסקנה: להיכלל ברשימות "הכי טוב" של אחרים מנצח לפרסם רשימה כזו על עצמכם.
הקו האדום: למה אסור לזייף נוכחות?
הפיתוי לזייף נוכחות, לשתול ביקורות או להרכיב רשימות "הכי טוב" באתרים ששכרתם, גדול, כי רשימות הן חלק גדול מהציטוטים (מחקר Evertune ב-Search Engine Land, מאי 2026: 63% מהציטוטים במדגם הפנו לרשימות). אבל זיוף מתגלה. GPTZero פרסמה חקירה שמצאה שרוב המקורות בדוח של EY Canada היו בדויים או שבורים, והדוח נמשך. איך מבדילים אמיתי מפייק? נוכחות אמיתית באה מגורם חיצוני בלי אינטרס: אתר עם שם, מחבר אמיתי, שיטת דירוג גלויה, וקישורים שמובילים למקורות קיימים. פייק מזוהה לפי אותו ניסוח שחוזר, גל פרסומים בחלון זמן צר, חשבונות בלי היסטוריה, וקישורים שמחזירים 404. ומעבר לכך, זיוף ביקורות הוא סיכון משפטי: ה-FTC הזהירה עשר חברות (דצמבר 2025) והזכירה אפשרות לעיצומים של עד 53,088 דולר להפרה. הכלל הפשוט: אם הנוכחות לא הייתה שורדת בדיקה של אדם סקפטי עם דפדפן פתוח, עדיף להשקיע בתוצאה אמיתית שמישהו יזכיר מרצונו.
אילו מקורות המנועים מצטטים, ואיך זה השתנה ב-2026?
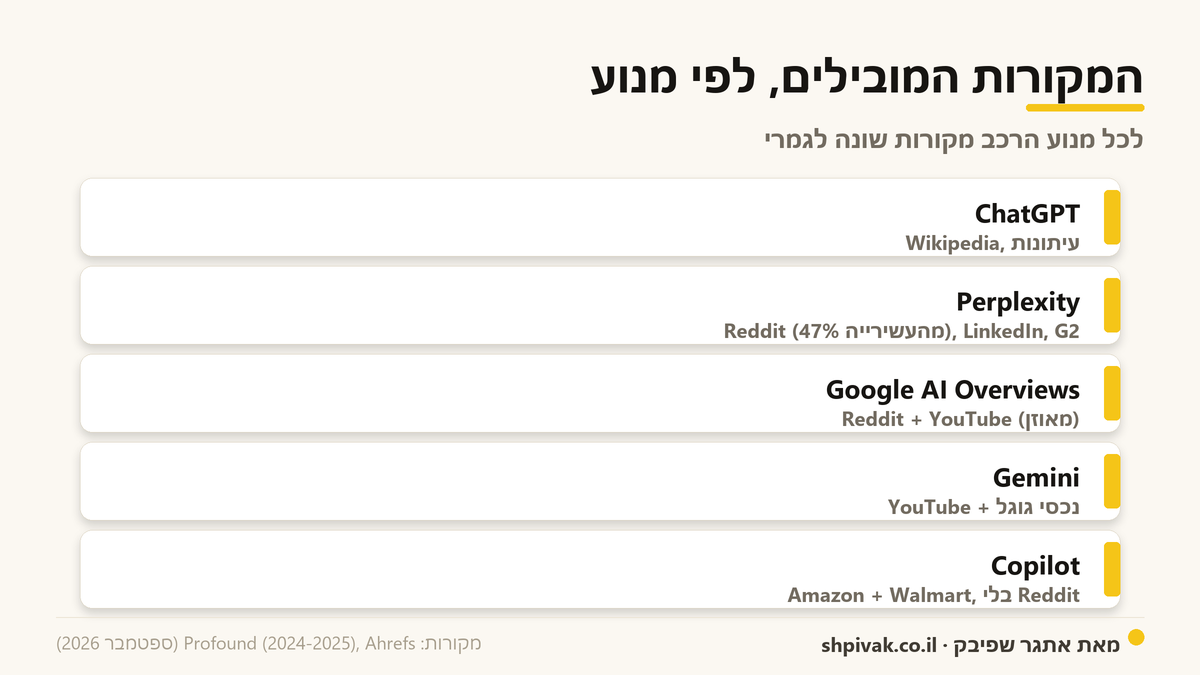
עד תחילת 2026 Reddit היה הדומיין הכי מצוטט (Peec AI, מרץ 2026). כבר בסוף 2025 YouTube עקף אותו בנתח הציטוטים מרשתות חברתיות (מ-18.9% ל-39.2% בין אוגוסט לדצמבר 2025, לפי Goodie AI), ובאוגוסט 2026 הנתח של Reddit בציטוטי ChatGPT צנח מ-3.8% ל-0.5% אחרי שינוי באופן החיפוש של ChatGPT (הסיבה עדיין לא אושרה). טרקר חי אחד (LLM Pulse, ספטמבר 2026) מציב את YouTube ראשון ואת Reddit שלישי בערך. הנקודה החשובה: לכל מנוע הרכב מקורות שונה לגמרי, ורק כ-11% מהדומיינים מצוטטים גם ב-ChatGPT וגם ב-Perplexity. לפי Profound (נתוני 2024-2025): ChatGPT נשען אז על Wikipedia ועל עיתונות (הנתח של Wikipedia ירד מאז מתחת ל-20%); Perplexity נשען חזק על Reddit (כ-47% מתוך עשרת המקורות המובילים שלו, לא מכלל הציטוטים), והוא המנוע היחיד ש-Reddit נשאר בו מלך; Google AI Overviews מאזן בין Reddit ל-YouTube; ו-Copilot חריג לגמרי (Ahrefs, ספטמבר 2026): נשען על אתרי קניות, Amazon ו-Walmart מובילים, בלי Reddit. המשמעות: אי אפשר להריץ אסטרטגיית מקורות אחת לכל המנועים, וגם הדירוג הזה זז מהר, אז אמתו אותו מול נתונים עדכניים לפני שאתם בונים עליו.
Reddit, ביקורות ו-YouTube: מה באמת שווה?
Reddit עדיין מהדומיינים המצוטטים ביותר, במיוחד ב-Perplexity וב-AI Overviews, אז נוכחות אמיתית שם (לא ספאם) שווה, גם אם ב-ChatGPT הוא כמעט נעלם מאז אוגוסט 2026. לשאלות "הכי טוב", אתרי ביקורות כמו G2 ל-B2B ו-Trustpilot ל-B2C הם מקורות שהמנוע מרים מהם. ו-YouTube: רוב המנועים לא צופים בווידאו, הם קוראים את התמלול. אז וידאו ארוך עם תמלול מפורסם הוא נכס GEO אמיתי, ולכן YouTube מטפס במהירות במקורות המצוטטים.
למה חוזק מותג הוא עמוד השדרה של הכול?
כל מה שכתבנו כאן מתכנס לנקודה אחת: ה-AI ממליץ על מי שהרשת כבר מכירה. לכן ההשקעה הכי משפיעה על GEO היא לרוב לא טכנית אלא שיווקית, בבניית מותג שמדברים עליו. וזה מוביל ישר לחלק הבא.
חיפושי מותג וסושיאל מדיה
חוזק מותג הוא מהמנופים הגדולים ל-GEO, וחיפושי המותג הם המדד שמראה אותו. חיפושי מותג ונראות AI מזינים זה את זה בשני הכיוונים: המלצת AI מגדילה חיפוש בשם, וחיפוש ואזכורי מותג מגדילים נראות AI. מחקר של Similarweb (יוני 2026, בניתוח של Rand Fishkin מ-SparkToro) מצא שמותג שה-AI ממליץ עליו סביר פי 2.5 לקבל ביקור באתר בשבוע שאחרי, רובו דרך חיפוש מותג. זו לולאה, לא משפך. הסתייגות: הנתון אגרגטיבי על מותגים גדולים, לא מוכח למותג קטן.
איך מייצרים ביקוש לחיפוש מותג?
פרסום מותג רחב-טווח שבונה זמינות מנטלית, כך שאנשים מחפשים אתכם בשם מאוחר יותר. PR ומה שאחרים אומרים עליכם, שמשתלמים פעמיים: קפיצה בחיפושי מותג ואזכורים מאונדקסים על דומיינים מהימנים (מה שה-AI מצטט). מובילות דעה ונראות של המייסד או המנהל, כי אנשים מחפשים את המותג בגלל האנשים (תוכן שמפרסם אדם מקבל בבירור יותר מעורבות מפוסט של עמוד מותג). דאטה מקורי חוזר, שהוא בו-זמנית פיתיון PR, מניע חיפוש מותג, וה-snippet שה-LLM מצטט. ונכסי מותג עקביים (שם, לוגו, צבעים), כי אותה עקביות מאפשרת ל-AI לזהות אתכם כישות אחת.
מתי חיפוש מותג הוא אות בריא, ומתי אשליה?
אות בריא: נתח חיפוש עולה ומתמשך מול מתחרים, גילוי לא-ממותג שהופך לחיפוש ממותג לאורך זמן, וחיפוש ממותג שממיר (כלל אצבע של מנהלי PPC, לא מחקר: בערך פי 2-3 מחיפוש לא-ממותג). אות אשליה: קפיצה חד-פעמית ממשבר יחסי ציבור, תעבורת בוטים שמנפחת מדדי סרק, תעבורה ממותגת קנויה (PPC ממותג) שנספרת כביקוש אורגני, או חיפוש ממותג שעולה אבל ההמרות שטוחות (סימן לבלבול או שם מתנגש).
אילו פלטפורמות סושיאל מזינות ציטוט, ואילו רק ביקוש?
התובנה המרכזית: AI מצטט טקסט מאונדקס וקריא, שנקרא כמו תשובה עצמאית. הוא לא מצטט "פלטפורמה", והוא לא מצטט מעורבות. מכאן הפלטפורמות מתפצלות לשתי משימות.
| מסלול | פלטפורמות | מה זה עושה |
|---|---|---|
| ציטוט ישיר (טקסט מאונדקס) | Reddit, YouTube (וידאו ארוך + תמלול), LinkedIn, Quora | נשלף ומצוטט ישירות בתשובות |
| ביקוש עקיף (בעיקר חזותי) | Instagram, TikTok | מניעים מודעות וחיפוש מותג, מצוטטים הרבה פחות מ-YouTube |
הבהרה על מונחים: Stories, Reels ו-Shorts הם פורמטים בתוך הפלטפורמות, לא פלטפורמות בפני עצמן. מה שקובע אם משהו מצוטט הוא הטקסט שהפורמט מייצר, לא השם שלו. Stories נעלמים אחרי 24 שעות ולכן אין להם כתובת קבועה לאינדוקס, וכמעט לא מצוטטים. Reels ו-Shorts הם וידאו עם מעט טקסט: ב-YouTube, Shorts היו רק 5.7% מהציטוטים לעומת 94% לווידאו הארוך (OtterlyAI, מרץ 2026).
לעומתם, פוסט פיד או קרוסלה באינסטגרם כן נכנסים לאינדקס של גוגל (מאז יולי 2025) והכיתוב שלהם יכול להזין תשובה.
נקודה שחשוב לתקן: מעורבות ותגובות לא גורמות לציטוט. פוסט עם המון תגובות לא נשלף יותר בגלל שהוא פופולרי, אלא רק אם הטקסט שלו מאונדקס וקריא כתשובה. במחקר של OtterlyAI על 100 מיליון ציטוטים (מרץ 2026), לייקים, צפיות ומנויים לא הראו מתאם עם תדירות הציטוט (41% מהסרטונים המצוטטים היו עם פחות מ-1,000 צפיות).
מה שכן מזיז: אורך התיאור וטריות התוכן. Reddit הוא היוצא מן הכלל: שם דווקא התגובות עצמן הן הטקסט שנשלף, כי הדיון הוא התוכן. בפייסבוק, אינסטגרם וטיקטוק מספר תגובות גבוה לא הופך את הפוסט לניתן לציטוט.
ומה עם X (טוויטר)? הוא כמעט לא מצוטט על ידי ChatGPT, Perplexity או Gemini, כי הוא חוסם סריקה בתנאי השימוש שלו. הדאטה שלו זורם ישירות ל-Grok דרך אינטגרציה פנימית של xAI, לא דרך הרשת הפתוחה. אז X הוא ערוץ ל-Grok בלבד, לא ערוץ נראות כללי.
איך עובדים עם סושיאל, לפי סוג העסק
בחרו קודם את הפלטפורמות מזינות-הציטוט לפי הקהל.
- B2B: בראש ובראשונה LinkedIn (המקור המצוטט ביותר לשאלות מקצועיות, Profound מרץ 2026) יחד עם YouTube ו-Reddit.
- B2C: הרשת החברתית Reddit (דעות על מוצרים), YouTube (ביקורות והסברים עם תמלול) ואתרי ביקורות כמו Trustpilot ו-G2.
בשני המקרים, אינסטגרם וטיקטוק הם שכבת מודעות שבונה את המותג שה-AI ימצא במקום אחר, לא הציטוט עצמו.
ודאו את קיומה של ישות עקבית בכל פרופיל, וודאו שכל פרסום מהותי מייצר גם גרסת טקסט מאונדקסת על דומיין שלכם: תמלול מלא ל-YouTube (פורסם על עמוד באתר שלכם או בתיאור הסרטון), פוסט טקסט, או סיכום כתוב.
מדדו את מה שבאמת חשוב: את נתח חיפושי המותג (Share of Search) ואת נתח הציטוט מול המתחרים, לא עוקבים ולייקים.
מחזור תוכן (Repurposing): פריט אחד, הרבה נכסים
מחזור תוכן הוא איך הופכים פריט אחד להרבה נכסים, שגם מגדילים עניין בסושיאל וגם את הנוכחות ב-AI.
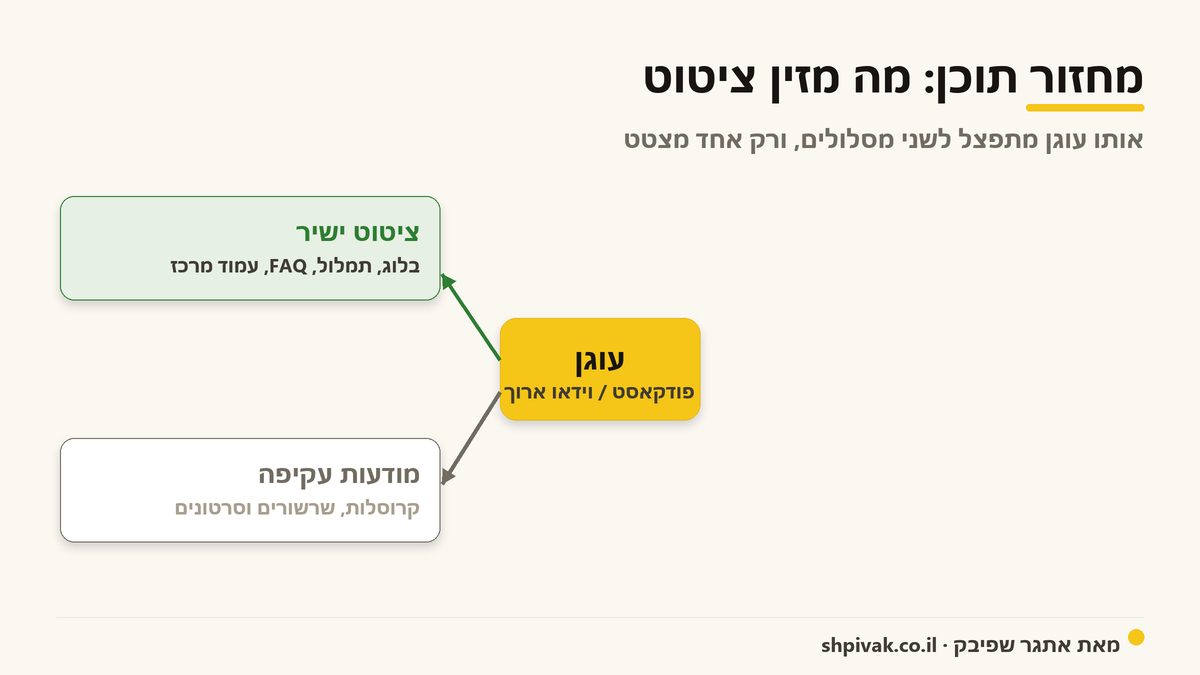
הטריק: לדעת אילו נכסים מזינים ציטוט ואילו רק מודעות. קליפים בסושיאל קונים תשומת לב וחיפוש מותג (ערך GEO עקיף). נכסי טקסט מאונדקס (בלוג, תמלול, FAQ) הם מה שה-AI באמת שולף ומצטט (ערך GEO ישיר). תוכנית מחזור שמייצרת רק וידאו ארעי מזינה את הראשון ומרעיבה את השני.
המודל: עוגן, פירוק, פורמט מקומי, מרכז
פריט עוגן אחד עשיר (פרק פודקאסט, וובינר, וידאו ארוך) שמכיל לפחות שלושה רעיונות נפרדים, מתפרק להרבה נכסים חד-רעיוניים, שמופצים בפורמט מקומי לכל פלטפורמה, ומתאחדים בעמוד מרכז (pillar) שבבעלותכם. זה המודל של Ross Simmonds ("Create Once, Distribute Forever"), שמעריך ש-85% מהמשווקים מקדישים 90% מהזמן ליצירה ומזניחים הפצה.
למה מחזור תוכן הוא ליבת GEO?
רוב מנועי ה-AI לא רואים אודיו או וידאו, הם קוראים את הטקסט סביבם: תמלול, כיתובים, כותרת, תיאור (Gemini הוא חריג שמעבד וידאו ישירות).
Reel או פרק פודקאסט גולמי, כשלעצמם, בלתי נראים לשליפה. המהלך שמייצר ערך GEO הוא להמיר את העוגן הארעי לטקסט מאונדקס ומובנה. ניסוי מעקב מצא שתמלולים נקיים צוטטו בערך פי שניים מתמלולים אוטומטיים גולמיים (מדגם קטן, כיווני).
איך עושים מחזור תוכן נכון?
רעיון אחד לכל נכס. התאימו את הפורמט לכל פלטפורמה, אל תפרסמו את אותו פוסט זהה בכל מקום (מה שנקרא cross-post, העתקה במקום עיצוב מחדש). תמיד פרסמו תמלול נקי (פיסוק, פסקאות, פסקת סיכום עתירת-ישויות) על דומיין משלכם, זה המהלך בעל המנוף הכי גבוה ואיפה שרוב המשווקים נכשלים. בנו עמוד מרכז שמאחד, חלצו את הסטטיסטיקה הכי טובה ואת ציטוט המומחה כשורות עצמאיות מיוחסות, ובנו FAQ מהשאלות שעלו.
FAQ: לבנות נכון, ומתי זה מוגזם
מבנה שאלה-תשובה הוא מהפורמטים בעלי הערך הגבוה ל-AI, כי הוא ממפה ישירות לאיך אנשים שואלים ולאיך המנוע מפרק פרומפט לתת-שאלות (fan-out). בלוק שאלה-תשובה עצמאי קרוב למקטע האידיאלי לשליפה. אבל קל להפוך אותו לתוכן קידום מזויף, וכאן ההבחנה.
מה קרה ל-schema של FAQ?
נקודה שחשוב לדייק בה: גוגל הסירה את תצוגת ה-FAQ העשירה מתוצאות החיפוש (ב-2023 הגבילה אותה לאתרי ממשל ובריאות, ובמאי 2026 ביטלה אותה לכולם). כלומר אין ויזואל FAQ בתוצאות כמעט לאף אתר. סכמת FAQPage עדיין תקינה ולא מזיקה: גוגל קוראת JSON-LD כמבנה לזיהוי ישות, ומנועי השליפה האחרים הופכים את העמוד לטקסט ולרוב מתעלמים מהבלוק. בשני המקרים מה שנשלף הוא הטקסט הגלוי על העמוד. אל תוסיפו schema כדי "לקבל rich result", אין כזה.
איך בונים FAQ נכון?
שאלות אמיתיות, לא מומצאות (מטיקטים של תמיכה, שיחות מכירה, "אנשים גם שואלים", Reddit, ומתשאול ישיר של ChatGPT). תשובה-ראשית של 40-60 מילה, ישירה במשפט הפתיחה, עצמאית. ספציפי, עם מספרים ותאריכים. גלוי ונגיש בעמוד, לא מוסתר. ואם מוסיפים FAQPage JSON-LD, כל שאלה ותשובה חייבות להופיע מילה במילה גם על העמוד.
מתי FAQ הופך למוגזם ונראה כמו קידום?
זו השאלה החשובה, כי הדפוסים האלה נקראים כספאם: שאלות דחוסות במילות מפתח, שאלות מומצאות ומובילות שהן בעצם מודעה ("למה [המותג] הוא הכי טוב"), בלוק FAQ זהה שמודבק על כל עמוד, וקופי שיווקי בתחפושת שאלה-תשובה. המבחן פשוט: האם אדם אמיתי היה שואל את זה במילים האלה? האם התשובה מיידעת קודם ומוכרת (אם בכלל) אחר כך? והאם היא יכולה לעמוד לבד כמשפט מצוטט, נכון ושימושי מחוץ להקשר? אם עניתם "לא" על אחת, תקנו.
ניתוח Fan-Out
fan-out הוא טכניקה של גוגל ב-AI Mode. במקום לענות על השאלה שלכם ישירות, המנוע מפרק אותה להרבה תת-שאלות, מריץ אותן במקביל, ומחבר תשובה. גוגל אישרה זאת (מאי 2025). המשמעות: דירוג למונח הראשי כבר לא מבטיח הופעה, כי התשובה מורכבת מהרבה תת-שאלות נסתרות, והמנוע מצטט את הפסקה הכי טובה לכל תת-שאלה.
זה לא רק גוגל. גם ChatGPT מפרק שאילתות, פשוט אחרת, ובררני יותר. כל מנוע מפרק אחרת, אז אותה שאלה מייצרת תת-שאלות שונות בכל מנוע.
פבל ישראלסקי, מנכ"ל Angora Media ושותף-מייסד ב-Chatoptic, מנתח לעומק את ה-AI Mode של גוגל, ומביא במדריך שלו שני נתונים: לפי Ahrefs (נתוני ספטמבר 2025) החפיפה בין העמודים שמצוטטים ב-AI Overviews לבין ה-AI Mode היא רק כ-13.7%, ולפי Semrush (יוני 2026) ה-AI Mode מזכיר פי 2.5 יותר שמות של מותגים ואנשים. כלומר גם בתוך גוגל עצמה, הופעה במיקום אחד לא מבטיחה הופעה בשני, וה-AI Mode נוטה עוד יותר לכיוון המותג המוכר.
איך זה מתחבר לקריסת הדירוג: מחקר Ahrefs (מרץ 2026) מצא שרק 38% מהעמודים שמצוטטים ב-AI Overviews מדורגים בעשירייה הראשונה, ירידה מ-76% ביולי 2025 (Ahrefs מעירים שזיהוי הציטוטים שלהם השתפר בין שתי הבדיקות, אז חלק מהירידה נובע מהשיטה ולא רק מהמנוע). יש כאן מחלוקת שכדאי להכיר: BrightEdge מדדו חפיפה של רק 17%, ו-5W מדדו קריסה מ-70% לפחות מ-20%. כולם מסכימים שהחפיפה קרסה, המספר המדויק שנוי במחלוקת. ההסבר המקובל הוא fan-out, גם אם חלק מהפער נובע משינוי בשיטות המדידה.
מה שעושים עם זה: לבחור שאילתת מטרה מסחרית, לייצר את תת-השאלות שלה (בסימולציה או בצפייה בפאנל המקורות של AI Mode), למפות אילו מהן אתם מכסים ואילו לא, ולתדרך תוכן לכל פער. עדיף להוסיף פסקה עצמאית לעמוד קיים מאשר לפתוח עמודים דקים חדשים.
מחולל תת-שאלות (fan-out ידני)
מה עושה: מזינים נושא, והכלי מציע רשימת תת-שאלות סבירות לפי היבטים (הגדרה, איך, עלות, השוואה, סיכונים, אלטרנטיבות), כצ'קליסט לכיסוי. קלט: נושא. פלט: עץ תת-שאלות + ייצוא לקובץ אקסל או CSV. הערה כנה: fan-out אמיתי הוא בצד המנוע, זה כלי עזר ידני לרעיונות, לא חשיפה של השאילתות האמיתיות. רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
E-E-A-T: לבנות אמון שהמכונה קוראת
E-E-A-T הם ניסיון, מומחיות, סמכות ואמון (Experience, Expertise, Authoritativeness, Trust). חשוב לדייק בשתי נקודות שגוגל כותבת במפורש: במסמך Creating Helpful Content, E-E-A-T אינו גורם דירוג בפני עצמו אלא מסגרת מושגית; ובהנחיות מעריכי האיכות (גרסת ספטמבר 2025), אמון (Trust) הוא החשוב ביותר, וכל השאר בונה אותו. אז את האמון בודקים קודם.
למה זה כפול חשוב ל-GEO: אלגוריתם דירוג יכול לשקלל מאות אותות ועדיין לדרג עמוד חלש במקום שביעי. מנוע תשובה מצטט מעט מקורות, לרוב שניים עד חמישה. לכן אות אמון שרק מזיז דירוג בגוגל יכול לשמש שער לציטוט AI. והמנוע קורא אמון מאותות קריאים למכונה: byline (שורת הקרדיט שמציינת מי כתב, "מאת [שם]"), עמוד ביו של המחבר, schema של Person, sameAs, ואישוש חיצוני.
איך בונים בפועל: מחבר נקוב עם אישורים אמיתיים בכל עמוד מהותי, שמקושר לעמוד ביו ייעודי; ניסיון ממקור ראשון (צילומים מקוריים, "בדקנו את זה בעצמנו", דאטה מקורי שאתם הפקתם); ציטוט מקורות ראשוניים; ובצד האמון, עמוד About אמיתי, יצירת קשר עם כתובת, תאריכי עדכון גלויים, ועובדות שאינן סותרות בין עמודים.
מדידה ומעקב שוטף
איך מודדים חינם, לבד?
שיטת ה-DIY היא קבוצה קבועה של 15 עד 25 שאלות בכוונת קנייה, מורצת חודשית על פני המנועים, ומתועדת בגיליון: תאריך, מנוע, האם צוטטתם, מיקום, אילו מתחרים. זו גרסה ידנית של מה שכלים בתשלום עושים אוטומטית, ובלי פרטים שיוצאים החוצה.
מחולל ספריית פרומפטים
מה עושה: מזינים מותג, קטגוריה, ומתחרים, והכלי מרכיב כעשרה עד חמישה-עשר פרומפטים באשכולות של מותג, קטגוריה והשוואה, מוכנים למעקב. קלט: מותג + קטגוריה + מתחרים. פלט: רשימת פרומפטים + ייצוא לקובץ אקסל או CSV. מזין את הכלי הבא. רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
יומן מעקב פרומפטים וציטוטים
מה עושה: יומן פרטי לתעד לכל פרומפט/מנוע/תאריך אם הוזכרתם, צוטטתם, ומה הסנטימנט. מייצא לקובץ אקסל או CSV, כך שה"מסד נתונים" נייד בלי שרת. קלט: פרומפט, מנוע, תאריך, תוצאה. פלט: טבלה + סיכומים + ייצוא. זו החלופה החינמית לכלים של 200 דולר לחודש, כי הרצת פרומפטים אוטומטית מול המנועים דורשת API בתשלום ושולחת נתונים החוצה. הכלי הזה רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור, וזו בדיוק הנקודה.
מה מוציאים מהמערכות הרשמיות?
ב-Search Console של גוגל הקליקים והחשיפות מ-AI Overviews ומ-AI Mode נבלעים מ-2025 בתוך הדוח הרגיל בלי אפשרות להפריד; דוח ייעודי מיוני 2026 (Generative AI performance) מפריד רק חשיפות, בלי קליקים ובלי שאילתות.
Bing Webmaster Tools מציג ציטוטים של Copilot בלבד (לא ChatGPT), אבל הוא הדרך לוודא שאתם באינדקס ש-Copilot שואב ממנו. ב-GA4 יש מ-2026 ערוץ "AI Assistant", אבל הוא חלקי: Perplexity עדיין נופל תחת Referral, וקליקים מ-AI Overviews נספרים כ-Organic, אז עדיף עדיין להגדיר regex מותאם (ביטוי רגולרי, תבנית טקסט שתופסת את הכתובות של מנועי ה-AI).
פבל ישראלסקי מציע כאן שיטה שעוקפת את מגבלת ה-GSC (המדריך שלו): לסנן ב-Search Console שאילתות פרומפט ארוכות (10 מילים ומעלה) עם regex, וזה עדיין עובד.
הטכניקה השנייה, מעקב אחרי פרמטר ה-Text Fragment בכתובת (#:~:text=) שהגיע מתשובת AI דרך Google Tag Manager, הפסיקה לעבוד במאי 2026 כשגוגל הסירה את הפרגמנט מקישורי ה-AI Overviews, אז שווה להכיר אותה בעיקר היסטורית. את הטכניקות פבל מייחס ל-Brodie Clark (שזיהה את שיטת ה-Text Fragments) ול-Dana DiTomaso (הגדרת ה-GTM וה-GA4).
מחולל Regex לזיהוי תעבורת-AI ב-GA4
מה עושה: בוחרים אילו מנועים לכלול, והכלי מחולל את ה-regex המדויק ואת מסלול ההגדרה ב-GA4, עם הסבר לכל חלק. קלט: בחירת מנועים. פלט: regex + הוראות הגדרה (כולל תפיסת session_source ו-utm_source=chatgpt.com, לא רק referrer, והתאמה לערוץ AI Assistant החדש ב-GA4). הכול רץ בדפדפן בקוד רגיל, בלי בינה מלאכותית מאחור.
וזכרו את בעיית התעבורה האפלה: חלק גדול מביקורי ה-AI מגיעים בלי מקור הפניה ונופלים תחת "ישיר". כל מספר תעבורת AI הוא רצפה, לא האמת. לכן מסתכלים על שלושה אותות יחד: תעבורת AI, נתח קול, ועלייה בחיפושי המותג.
הכלים של המומחה: חובה, נחמד, או דלג
ההבדל בין מומחה למי שקונה כל כלי שיוצא הוא היכולת לדרג. רוב המנוף האמיתי והזול נמצא בבהירות ישות ובאמת הקרקע של לוגי השרת. Schema ורוב כלי הדאטה המובנה הם היגיינה, לא זרוע. הנה פסק הדין המדורג, נכון לספטמבר 2026 (המחירים מדגימים, אמתו לפני שאתם מצטטים ללקוח).
חובה, וכמעט הכול חינם
- הבסיס החינמי כיחידה: Google Search Console, Bing Webmaster Tools (מזין את ChatGPT ו-Copilot), GA4, ותשאול ידני של המנועים. בדיקת המציאות הכי מהירה לפני כל כלי בתשלום.
- Cloudflare Agent Readiness Score (חינם, isitagentready.com): סורק שנותן לכל כתובת ציון 0-100 עד כמה היא קריאה לסוכני AI. הריצו כמעבר ראשון על כל לקוח. הסתייגות: זה סורק צ'קליסט, הוא אומר אם הדלת פתוחה, לא אם מישהו נכנס.
- Cloudflare AI Crawl Control (חינם, אם האתר על Cloudflare): מראה אילו סורקי AI באמת הגיעו, כמה בקשות, והאם כיבדו robots.txt. זו אמת קרקע בצד השרת, האות הכי קשה לזייף. חשוב: Cloudflare התחילה לחסום סורקי AI כברירת מחדל בדומיינים חדשים ביולי 2025, אז הרבה אתרים בלתי נראים ל-AI בלי לדעת. כאן מאבחנים את זה.
- Screaming Frog SEO Spider (כ-£199 לשנה): הפיצ'ר הקריטי הוא כיבוי רינדור JavaScript כדי לראות אם התוכן קיים ב-HTML גולמי.
- Wikidata ו-Google Knowledge Graph Search API (חינם): מנוף הישות.
- מאמתי schema החינמיים (Rich Results Test, Schema Validator): היגיינת QA.
נחמד שיהיה, לפי היקף
ניתוח לוגים בקנה מידה (JetOctopus, ~$549 לחודש; או Screaming Frog Log Analyser ב-£99 לשנה לגרסה הזולה), כלי תוכן אחד (Surfer, Frase או Clearscope), ו-Kalicube Pro ללקוחות ממוקדי ישות עם תקציב.
מה לדלג עליו
כלים שמוכרים "schema עשיר = יותר GEO" במחיר אנטרפרייז (היגיינה יקרה), ופיצ'רי החסימה והמונטיזציה של Cloudflare (Managed robots.txt, AI Labyrinth, Pay per crawl). תפקידכם עם האחרונים הוא רק לוודא שהם לא מסתירים בטעות את האתר מהסורקים שאתם רוצים.
מיתוסים ומה לא עובד
חבל לבזבז תקציב על מה שלא מזיז. הנה מה שמנופח:
- llms.txt. קובץ שאמור להנחות מנועי AI. Ahrefs בדקו ומצאו ש-97% מהקבצים לא קיבלו אף בקשה. גם נתי אלימלך וגם אנידור חקק ממעיטים בערכו. נתי מגבה את זה בראיות: תיעוד גוגל, סיווג Lighthouse תחת "גלישה אג'נטית" ולא SEO, ולוגים של עשרות אתרים גדולים ואתרי SaaS שמראים שהקובץ נשלף בפחות מ-1 ל-10,000 בקשות בוט, ובלוגים בקנה מידה של Wix השימוש היה אפסי (הפוסט שלו). זול להוסיף, אבל אל תמכרו אותו כטקטיקה.
- Schema לבד לא קונה ציטוטים. הוא היגיינה שעוזרת לזיהוי ישות, לא מנוף ישיר.
- דחיסת מילות מפתח מזיקה. מאמר ה-GEO המקורי מצא שזו הטקטיקה היחידה שהורידה נוכחות. טקטיקות של מנוע חיפוש לא עוברות אחד לאחד למנוע גנרטיבי.
רמת מומחה: מה עוד צריך לדעת
השכבה שמפרידה מקצוען מחובב.
שני משחקים, שני שעונים
יש הבדל בין להיות בזיכרון של המודל מהאימון (מה שהוא "יודע" עליכם, קפוא בנקודת חיתוך הידע, משתנה לאט מאוד) לבין להישלף בזמן אמת (מהיר, שליט, וכאן חיים הציטוטים). לזכות בציטוט זו עבודה ברמת העמוד והפסקה. לשנות מה שהמנוע "מאמין" עליכם כשהחיפוש כבוי זו עבודת ישות ומוניטין לטווח ארוך.
איך מנהלים הזיות של המנוע?
לפעמים המנוע מתאר אתכם לא נכון. מחקר Tow Center של Columbia Journalism Review (מרץ 2025, 1,600 שאילתות על שמונה מנועים) מצא שיותר מ-60% מהתשובות ייחסו ציטוטים עיתונאיים למקור הלא נכון. המחקר בדק ייחוס של כתבות, לא תיאור מותגים, אבל המנגנון זהה: המנוע עונה בביטחון גם כשהוא טועה, ולעיתים ממציא במקום להודות שאינו יודע.
הזיה על מותג היא לרוב מקור ישן או סותר שהמנוע חוזר עליו, אבל ריקנות מידע מסוכנת לא פחות, כי אז הוא ממלא את החסר בעצמו. האתר שלכם הוא רק חלק קטן ממה שהמודל קורא עליכם, רוב התמונה מגיעה ממקורות חיצוניים (הערכה רווחת בתחום, לא נתון ממחקר מבוקר), אז התיקון הוא בעיקר לתקן את המקורות החיצוניים ולהפוך את הישות לחד-משמעית.
מולטימודל: למה YouTube הוא הסיפור?
רוב המנועים לא צופים בווידאו, הם קוראים את שכבת הטקסט: תמלול, כותרת ותיאור. Gemini הוא היוצא מן הכלל, הוא מעבד וידאו ואודיו ישירות, ומספטמבר 2026 גוגל מכניסה יכולת כזו גם ל-Ask YouTube.
גם אז, מה שנותן לשאר המנועים פסקה לצטט הוא התמלול הנקי על עמוד שלכם. YouTube מצוטט הרבה, בעיקר דרך AI Mode, AI Overviews ו-Perplexity, ורוב הציטוטים הם וידאו ארוך ולא Shorts. אז וידאו עם תמלול נקי ומפורסם הוא אחד הנכסים הכי בעלי מנוף.
הרשת האג'נטית: למה זה מעניין כבר עכשיו?
עולם מתהווה שבו סוכני AI פועלים בשם המשתמש: מחפשים, משווים ואפילו קונים. כבר יש פרוטוקולים חדשים בעולם הזה: MCP של Anthropic מחבר סוכן לכלים ולנתונים, ו-ACP (OpenAI ו-Stripe) ו-AP2 (גוגל) הם פרוטוקולי מסחר ותשלום שנבנים מעליו.
נתי אלימלך כתב על WebMCP, ממשק ניסיוני שמאפשר לאתר לחשוף לסוכן פעולות מוכנות במקום שהסוכן ינחש איפה ללחוץ (הפוסט שלו). הסטטוס נכון ל-2026: ניסיוני בלבד, רץ כ-Origin Trial בכרום (גרסאות 149-156) שמסתיים בנובמבר 2026, ורק חלק מהסוכנים תומכים. נתי ממליץ לא להטמיע בסביבת ייצור עדיין, אבל כן להתנסות בזרימה בודדת. מה שאומרים ללקוח: ייתכן שהקנייה תעבור מגלישה אנושית לסוכן שפועל, אז נגישות למכונה ופידים עשויים לגבור על עמוד יפה. אבל ביושר: OpenAI סגרה את ה-Instant Checkout בצ'אט במרץ 2026, אחרי שרק עשרות סוחרים הצטרפו (הפרוטוקול ACP ממשיך). הכינו את התשתית, אל תסמכו עליה לרבעון הקרוב.
הניואנס העברי: כדאי להשקיע בעברית?
עברית היא שפה עם פחות נתוני אימון, והמודלים נשענים הרבה על אנגלית. לשאלה בעברית המנוע עלול לשלוף מקורות אנגליים ולתרגם, מה שנותן יתרון מבני למקורות בינלאומיים על פני אתרי co.il.
אז האם להשקיע בעברית? כן, בהחלט. הקהל הישראלי שואל בעברית ויש פחות תחרות, אז יש הזדמנות למי שמקדים. פשוט צריך גם לוודא שהישות שלכם עקבית בעברית ובאנגלית, כדי שהמנוע יחבר את שתי הזהויות לאחת. נקודה מבנית: ChatGPT ו-Copilot שואבים חלקית מ-Bing, והאינדקס העברי של Bing דל מזה של גוגל, אז אתר ישראלי שלא מאונדקס ב-Bing כמעט לא יופיע שם. הראיות על אופטימיזציה מסחרית בעברית עדיין מוגבלות, בעיקר הערכות, אז אני מסמן את זה ככזה.
יש כאן גם מחקר ישראלי אחד ששווה להכיר, בזהירות. מחקר Chatoptic (ספטמבר 2025) של פבל ישראלסקי, בהנחיית ד"ר עומר בן-פורת, חוקר ומרצה בטכניון (שהשתתף באופן עצמאי, לא בשם המוסד), מצא שמותגים שדורגו בעמוד הראשון בגוגל הוזכרו בתשובות ChatGPT רק ב-62% מהמקרים. חשוב לדייק: המחקר נבדק על 15,000 פרומפטים באנגלית בשוק האמריקאי, לא בעברית ולא בישראל. אז הוא ראיה לכך שדירוג קלאסי אינו נראות ב-AI, לא נתון על חיפוש בעברית.
אתרי תוכן וחדשות: שעון אחר
אם אתם מפרסמים תוכן חדשותי, המשחק שונה. נתי אלימלך מפרט שבעה נושאים (המדריך), והנה העיקר: לכתבת חדשות יש חלון קצר להיכלל ב-News Sitemap (כ-48 שעות), אז צריך אינדוקס מהיר (News Sitemap יחד עם WebSub שמודיע לגוגל על כל כתבה), סכימת NewsArticle עם תאריכי פרסום ועדכון מדויקים, ורינדור בצד השרת כך שהכותרת והגוף כבר ב-HTML הראשוני. מהירות היא המלצה תפעולית חזקה, אבל היא לא תנאי סף רשמי ל-Top Stories: גוגל אומרת במפורש שעמוד יכול להיכלל בלי קשר לציון Core Web Vitals. ונקודה שקשורה ישר ל-GEO: באמצע 2026 מפרסמים גדולים (Reddit, Gannett, Reuters) שקלו להגביל את גישת גוגל בגלל אובדן תנועה ל-AI Overviews, ורגולציה בריטית (CMA) מחייבת את גוגל, מיוני 2026, לאפשר opt-out בלי עונש דירוג (עם תשעה חודשים ליישום).
סדר עדיפויות: מה לעשות קודם
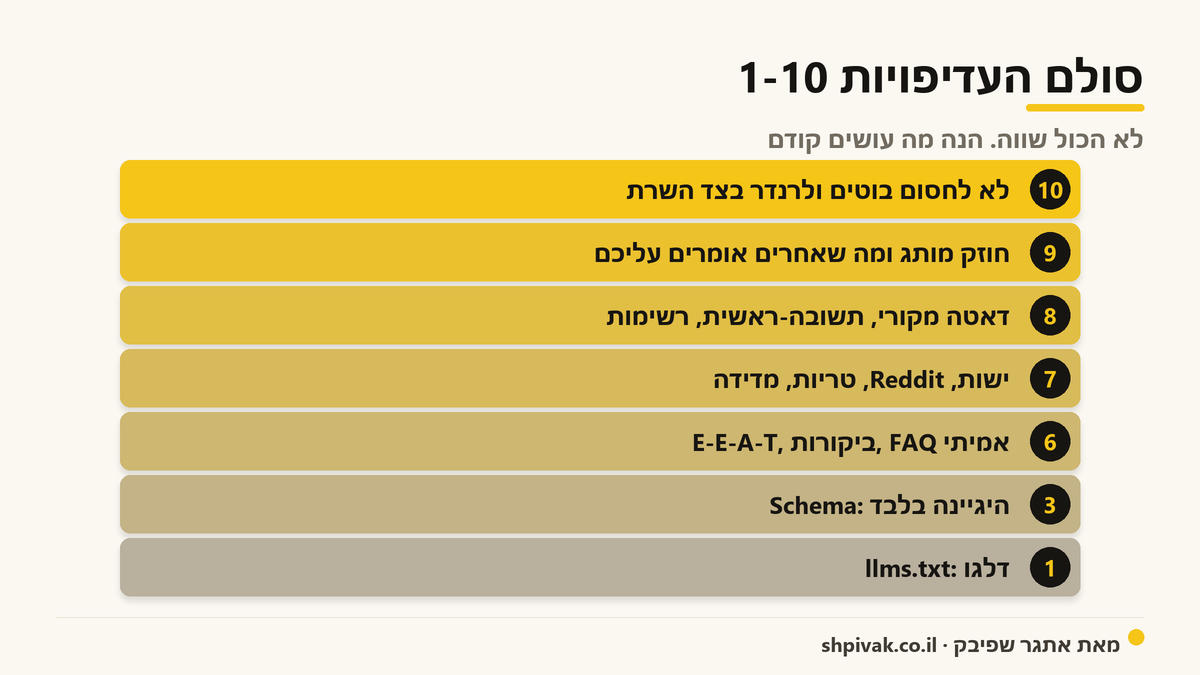
אם יש דבר אחד שמבדיל מומחה ממי שקונה כל כלי שיוצא, זו היכולת לדרג. הנה סדר העדיפויות שלי, מהחשוב והדחוף לפחות משפיע. 10 הוא "עשו קודם", 1 הוא "כמעט לא משנה". המספר הוא ציון השפעה משוער, לא דירוג רציף, ולכן חלק מהמספרים מדלגים.
- 10: לוודא שהבוטים מגיעים ורואים תוכן, ולרנדר בצד השרת. תנאי מקדים. אם הבוט מקבל 403 (לרוב מ-WAF, לא מ-robots.txt) או לא רואה תוכן, אתם מקבלים אפס בלי קשר לאיכות. חסימת בוטי אימון היא החלטה עסקית נפרדת.
- 9: חוזק מותג ומה שאחרים אומרים עליכם. המנוף הגדול, אם כי איטי ויקר. כאן יושבים 84% מהציטוטים.
- 8: דאטה מקורי וסטטיסטיקות בתוכן, מבנה תשובה-ראשית, כניסה לרשימות צד שלישי, ונוכחות YouTube עם תמלול.
- 7: בהירות ישות (Wikidata), נוכחות ב-Reddit, טריות, מחזור תוכן, ומחקר הפרומפטים והמדידה.
- 6: E-E-A-T של מחבר, אתרי ביקורות, פורמט לפי סוג שאלה, ו-FAQ אמיתי.
- 3: Schema. היגיינה, לא מנוף.
- 1: llms.txt. דלגו.
מומחים גלובליים
Rand Fishkin (מחקר zero-click, "קהל מעל תעבורה"), Mike King מ-iPullRank (GEO טכני, "relevance engineering"), Aleyda Solis (הניוזלטר #SEOFOMO), Lily Ray (E-E-A-T וניתוח AI Overviews), Kevin Indig (מסות GEO מעמיקות), Marie Haynes (אותות אמון), ו-Dan Petrovic מ-Dejan (ניסויי שליפה של LLM).
מומחים ישראליים
שילבתי את הרעיונות שלהם לאורך המדריך, וכאן מרכז אותם.
נתי אלימלך, לשעבר ראש ה-SEO והנגישות ב-Wix ומנכ"ל SEO ישראל, והיום יועץ GEO ו-SEO טכני עצמאי, מפרסם מהתוכן הטכני המהותי ביותר בעברית (natielimelech.com/geo). אנידור חקק, מייסד ומנכ"ל היידה דיגיטל ומרצה לקידום אתרים ושיווק דיגיטלי בקריה האקדמית אונו (ולאחרונה גם GEO), מפרסם מדריך GEO מקיף בעברית (hayde.co.il). פבל ישראלסקי, יועץ GEO ו-SEO ומי שכתב את הערך GEO בוויקיפדיה, מנכ"ל Angora Media ומייסד שותף ב-Chatoptic, כותב את הבלוג AskPavel (askpavel.co.il/blog).
מה שנתי ואנידור מסכימים עליו, ושונה מהזרם: שניהם ממעיטים בערך llms.txt (ונתי מגבה את זה בראיות הכי חזקות), שניהם מעדיפים מדידת הסתברות-הופעה על פני הרצות חוזרות במקום צילום מסך בודד, ושניהם מדגישים שרינדור וסריקוּת מכריעים, ושה-GEO הוא שכבה על SEO ולא תחליף. נתי מוסיף ש"יחידת המידע היא הפסקה, לא הדף", ואנידור מדגיש את ההזדמנות העברית-first: ה-AI כבר עונה על שאלות מסחריות בעברית, ורוב האתרים הישראליים עוד לא הותאמו.
מאיפה מתחילים: תוכנית 90 יום
אם כל זה נשמע לכם הרבה, הנה הסדר המעשי, בלי לקרוא הכול.
- שבוע 1, השער הטכני. לוודא בלוגים שבוטי החיפוש והשליפה מקבלים 200, ושהתוכן המרכזי ב-HTML הראשוני. בלי זה ה-AI פשוט לא רואה אתכם, וכל השאר לא רלוונטי. במקביל לוודא שהאתר מאונדקס ב-Bing, שמזין חלק ממנועי ה-AI.
- שבועות 2 עד 4, ישות ובסיס מדידה. ליישר את הישות (שם, פרופילים,
sameAs) כך שתהיה עקבית, ולצלם בסיס: 30 עד 50 שאלות מפתח, ובכמה מהתשובות מזכירים ומצטטים אתכם מול המתחרים. - חודשים 2 עד 3, מותג ותוכן שנשלף. מה שאחרים אומרים עליכם, דאטה מקורי שאפשר לצטט, עמודי השוואה עם תשובה-ראשית, ונוכחות YouTube עם תמלול מפורסם.
- שוטף. לעקוב אחרי המדדים המובילים בקצב שבועי, להחליט ולדווח פעם בחודש, ולאמת כל מספר מול נתונים עדכניים.
עשר טעויות שהורגות GEO בשקט
- לחסום בטעות את בוט השליפה עם כלל
User-agent: *, ואז להיעלם מהתשובות בלי לדעת. - להגיש את התוכן המרכזי רק בצד הלקוח (CSR), כך שהבוטים רואים דף ריק.
- למצע נתונים בין מנועים, במקום להריץ אסטרטגיה נפרדת לכל אחד.
- לרדוף אחרי schema כאילו הוא מנוף, במקום להשקיע בבהירות ישות.
- לפתוח עמודים דקים חדשים במקום להוסיף פסקה עצמאית לעמוד קיים.
- לשפוט את המנוע לפי הרצה בודדת, במקום מדגם שאלות קבוע שרץ שוב ושוב.
- לבנות רשימת "הכי טוב" על עצמכם, במקום להיכלל ברשימות של אחרים.
- למכור ללקוח מיקום מובטח או ייחוס מדויק. שום פלטפורמה לא נותנת את זה.
- למדוד רק את ChatGPT, ולשכוח את ה-AI Overviews של גוגל, שם נעצרת הכי הרבה תנועה.
- לחכות למספר מושלם לפני שמתחילים למדוד, במקום להתחיל עכשיו ולתקן תוך כדי.
סיכום
GEO הוא לא באג ולא באזז, זו הדרך שבה חלק גדל והולך מהקהל שלכם מגלה דברים. הדבר הכי חשוב חוזר על עצמו כמעט בכל מחקר של 2026: מה שעבד תמיד בשיווק, מותג חזק, מוניטין אמיתי ותוכן שבאמת עוזר, הוא בדיוק מה שגורם למנוע להמליץ עליכם. ההבדל הוא שעכשיו צריך גם להפוך את זה לקריא למכונה. תתחילו מהיסודות, תמדדו נכון, ואל תרדפו אחרי הטריקים. זה תהליך של חודשים, לא של שבוע, ומי שמתחיל עכשיו יהיה שם לפני שרוב השוק בכלל מתחיל.
עברתם את המדריך וזיהיתם פערים שאתם רוצים לסגור? זה בדיוק העיסוק שלי מול לקוחות. אם תרצו עזרה, כתבו לי.
על הכותב. אתגר שפיבק הוא ראש התמחות בקריה האקדמית אונו. ב-2018 היה ממייסדי Fixel וניהל אותה כמנכ״ל, וב-2020 רכשה אותה Logiq. היום הוא עובד עם יזמי Seed ו-Series A על שיווק ו-go-to-market, כולל האופן שבו מנועי AI מתארים את החברה שלהם. עוד עליו בעמוד האישי, ומדריכים נוספים במדור הכתיבה.
המדריך הזה נכתב בספטמבר 2026 והנתונים בו מעודכנים לאותה תקופה. התחום זז מהר, אז אמתו כל מספר לפני שאתם מציגים אותו ללקוח.
הכלים במדריך
כל שלושה-עשר הכלים של המדריך, במקום אחד. כולם רצים אצלכם בדפדפן, שום נתון לא נשלח לשום מקום. אפשר לחזור לכל אחד, ולהעתיק קישור ישיר אליו (לשמירה או שיתוף) מתוך הכלי עצמו.
- כרטיס ניקוד מוכנות GEO
- מחשבון נתח קול ב-AI
- תבנית לוח מחוונים (KPI) ל-GEO
- בודק גישת סורקי-AI ומחולל robots.txt
- צ'קליסט אודיט GEO
- מנתח "תשובה קודם" ויכולת ציטוט
- מחולל סכימת Organization ו-Person
- מחולל בלוק "עובדות מפתח" ושאלות נפוצות
- בודק עקביות ישות (NAP)
- מחולל תת-שאלות (fan-out)
- מחולל ספריית פרומפטים
- יומן מעקב פרומפטים וציטוטים
- מחולל Regex לתעבורת-AI ב-GA4
שאלות ותשובות
מה זה GEO?
מה ההבדל בין GEO ל-SEO?
כמה שווה נתח השוק של ChatGPT?
כמה זמן לוקח עד ש-GEO מראה תוצאות?
מה הכי משפיע על נראות ב-AI?
האם schema (דאטה מובנה) עוזר ל-GEO?
מאיפה מגיעים רוב הציטוטים של ה-AI?
מה עושים קודם ב-GEO?
האם צריך קובץ llms.txt?
אפשר למדוד נראות ב-AI בחינם?
חסמתי בטעות את בוטי ה-AI, איך בודקים?
User-agent: * ופותח רק ל-Googlebot, כך שבוטי ה-AI (שאין להם כלל ייעודי) נופלים תחת הכלל החוסם. בדקו את robots.txt מול רשימת ה-user agents של כל מנוע (GPTBot, OAI-SearchBot, PerplexityBot ואחרים), ואמתו בלוגי השרת שהם באמת מקבלים 200. הכלי במדריך בודק את זה עבורכם.
לציטוט: אתגר שפיבק, "המדריך המקיף ל-GEO: אופטימיזציה למנועי AI, מהבסיס ועד ליישום בפועל", shpivak.co.il, 16 בספטמבר 2026. https://shpivak.co.il/he/writing/geo-guide
הפרק הבא יגיע אליכם במייל. מייל אחד על כל פרק חדש של Founders' Marketing Compass, עם השיחה (באנגלית), חותמות זמן לכל נושא ועיקרי הדברים, ושום דבר בין לבין. להרשמה ב-Substack